本文属于机器翻译版本。若本译文内容与英语原文存在差异,则一律以英文原文为准。
# 情节记忆策略
**情景记忆可以**捕捉用户和系统交互的有意义的片段,因此应用程序能够以一种专注、相关的方式回忆上下文。它不是存储每个原始事件,而是识别重要时刻,将其汇总成紧凑的记录,然后进行整理,这样系统就可以毫无噪音地检索重要内容。这允许模型了解情境如何随着时间的推移而演变,从而创造出更具适应性和智能性的体验。
它的优势在于其结构化上下文涵盖许多互动,同时还能保持存储、搜索和更新的效率。开发人员无需设计自己的汇总流程即可在新鲜度、准确性和长期连续性之间取得平衡。
**反思**建立在情节记录的基础上,通过分析过去的情节来揭示见解、模式和更高层次的结论。反射不是简单地检索发生的事情,而是帮助系统理解某些事件为何重要以及它们应该如何影响未来的行为。它们将原始体验转化为应用程序可以立即使用的指导,为模型提供了一种从历史中学习的方式。
它们的价值来自于将信息置于个人时刻或情节之上,并创造持久的知识,从而改善决策、个性化和一致性。这可以帮助应用程序避免重复错误,更快地适应用户的偏好,并且在长时间内表现得连贯一致。
在了解过去一系列互动可以提高质量的任何场景中,以及需要长期改进的场景中,客户都应使用情景记忆。理想的用例包括客户支持对话、代理驱动的工作流程、依赖会话历史记录的代码助手、个人生产力工具、故障排除或诊断流程,以及需要以真实先前事件而不是静态配置文件为背景的应用程序。
当你调用情节策略时, AgentCore 会自动检测对话中的情节完成情况,并将事件处理成结构化的剧集记录。
**策略中的步骤 **
情节记忆策略包括以下步骤:
+ **提取 ** — 分析正在进行的剧集并确定剧集是否完成。
+ **整合 ** — 剧集完成后,将提取内容合并为单集。
+ **反思 ** — 见解是跨剧集生成的。
**策略输出 **
情节记忆策略返回情节和反思的 XML-formatted 输出。每个情节都分为情境、意图、评估、理由和剧集层面的反思。随着互动的进行,将逐一分析情节。您可以使用这些信息来更好地了解操作顺序和工具的使用。
**此策略捕捉的剧集示例 **
+ 一种代码部署交互方式,其中代理选择了特定的工具,遇到了错误,并使用替代方法成功解决了错误。
+ 一项预约重新安排任务,它记录了用户的意图、代理使用特定工具的决定以及成功的结果。
+ 一种数据处理工作流程,记录了哪些参数为特定数据类型带来了最佳性能。
情节策略包括记忆提取和巩固步骤(与其他策略共享)。此外,情节策略还会产生反思,在互动发生时在后台分析情节。反思汇总在多个情节中,以获得更广泛的见解,从而确定成功的策略和模式、潜在的改进、常见的失败模式以及跨越多种互动的经验教训。
**反射的例子包括 **
+ 确定哪些工具组合能够持续为特定任务类型带来成功结果。
+ 识别失败尝试中的模式以及解决这些模式的方法。
+ 从多个具有相似场景的成功剧集中提取最佳实践。
下图说明了情节记忆策略:
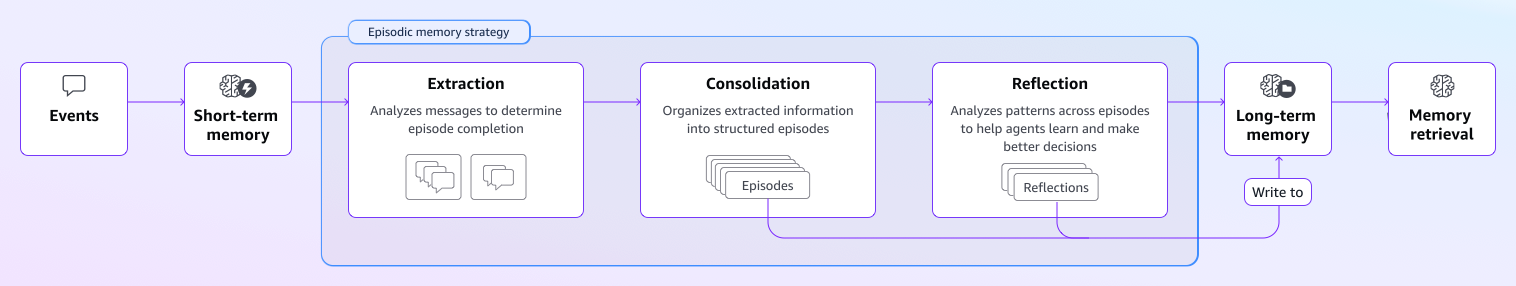
通过引用存储的剧集,您的经纪人可以通过语义搜索检索相关的过去经历并回顾反思,以避免重复失败的方法,并使成功的策略适应新的环境。这种策略对于受益于识别模式、需要持续更新信息、保持互动一致性、需要背景和推理而不是静态知识来做出决策的代理很有用。
**Topics**
+ [命名空间](#episodic-memory-strategy-namespaces)
+ [如何最好地检索剧集以提高代理性能](#memory-episodic-retrieve-episodes)
+ [系统提示情景记忆策略](memory-episodic-prompt.md)
## 命名空间
当你使用情节策略创建记忆时,你可以定义存储剧集和反射的命名空间。
**注意**
无论您选择在哪个命名空间中存储剧集,剧集始终由单个会话创建。
剧集通常存储在以下命名空间之一中:
+ `/strategy/{memoryStrategyId}/`— 在策略层面存储剧集。演员不同或来自不同会话但属于相同策略的剧集存储在同一个命名空间中。
+ `/strategy/{memoryStrategyId}/actor/{actorId}/`— 将所有剧集存储在演员级别。来自不同会话但属于同一个演员的剧集存储在同一个命名空间中。
+ `/strategy/{memoryStrategyId}/actor/{actorId}/session/{sessionId}/`— 将所有剧集存储在会话级别。属于同一会话的剧集存储在同一个命名空间中。
反射必须与剧集匹配相同的命名空间模式,但反射的嵌套程度可以降低。例如,如果您的剧集命名空间为`/strategy/{memoryStrategyId}/actor/{actorId}/`,则可以使用以下命名空间进行反射:
+ `/strategy/{memoryStrategyId}/actor/{actorId}/`— 将从所有剧集中提取演员的见解。
+ `/strategy/{memoryStrategyId}/`— 将从所有剧集和所有参与者中提取见解,以制定策略。
**重要**
由于反射可以跨越同一个内存资源中的多个参与者,因此在检索反射时要考虑跨角色分析的隐私影响。如果这是一个问题,可以考虑将[护栏与记忆结合使用,](https://github.com/awslabs/amazon-bedrock-agentcore-samples/tree/main/01-features/04-manage-context-of-your-agent/memory/03-integrations/03-guardrails-integration)或者在演员层面进行反思。
## 如何最好地检索剧集以提高代理性能
有多种利用情景记忆的方法:
+ 在您的代理代码中
+ 开始新任务时,将您的代理配置为执行查询,询问最相似的情节和反思。还要根据一些逻辑查询相关的情节和随后的反思。
+ 使用创建短期记忆时 [ CreateEvent](https://docs.amazonaws.cn/bedrock-agentcore-control/latest/APIReference/API_CreateEvent.html),包括`TOOL`结果将产生最佳结果。
+ 对于类似的成功剧集,对剧集中的回合进行线性化处理,仅将其提供给特工,这样它就可以专注于主要步骤
+ 手动方式
+ 看看你的反思或失败的剧集,并考虑更新代理代码是否可以解决一些问题
在执行检索时,请注意,记忆记录是根据剧集的 “意图” 和反思的 “用例” 编制索引的。
对于其他记忆策略,在整个交互过程中,内存记录会定期生成。相比之下,只有在Memory检测到已完成的剧集后,才会生成情节 AgentCore 记忆记录。如果剧集未完成,则生成将花费更长时间,因为系统会等待对话是否继续。