本文属于机器翻译版本。若本译文内容与英语原文存在差异,则一律以英文原文为准。
# 按需评估入门
按照以下步骤设置并运行您的第一个按需评估。
**Topics**
+ [先决条件](#prerequisites-on-demand)
+ [支持的框架](#supported-frameworks-on-demand)
+ [第 1 步:创建和部署您的代理](#create-deploy-agent-on-demand)
+ [第 2 步:调用您的代理](#invoke-agent-on-demand)
+ [第 3 步:评估代理](#evaluate-agent-on-demand)
+ [第 4 步:评估结果](#evaluation-results-on-demand)
## 先决条件
要使用 AgentCore 评估 OnDemand 评估功能,您需要:
+ ** Amazon **拥有相应 IAM 权限的账户
+ **使用模型调用**权限访问亚马逊 Bedrock
+ **在中**启用了交易搜索 CloudWatch -请参阅[启用交易搜索 ](https://docs.amazonaws.cn/AmazonCloudWatch/latest/monitoring/Enable-TransactionSearch.html)
+ **已安装 Python 3.10 ** 或更高版本
+ ** OpenTelemetry 库 ** — 在文件中包含 `aws-opentelemetry-distro` (ADOT) `requirements.txt`
## 支持的框架
使用 AgentCore 评估支持的框架和工具库构建您的代理。有关支持的框架和工具库的更多信息,请参阅[支持的代理框架](supported-frameworks.md)。
## 第 1 步:创建和部署您的代理
**注意**
如果您已在 AgentCore Runtime 中启动并运行代理,则可以直接转到步骤 2
按照 AgentCore 运行时[入门指南创建和部署代理](https://docs.amazonaws.cn/bedrock-agentcore/latest/devguide/runtime-getting-started.html)。您可以在[AgentCore 评估样本中找到其他示例](https://github.com/awslabs/amazon-bedrock-agentcore-samples/tree/main/01-features/06-observe-evaluate-optimize-your-agent/02-evaluate)。
## 第 2 步:调用您的代理
使用以下命令调用您的代理,然后在 GenAI 可观测性仪表板上查看跟踪、会话和指标。 CloudWatch
**Topics**
+ [示例 invoke\_agent.py](#example-invoke-agent)
### 示例 invoke\_agent.py
```
import boto3
import json
import uuid
region = "region-code"
ace_demo_agent_arn = "agent-arn from step-2"
agent_core_client = boto3.client('bedrock-agentcore', region_name=region)
text_to_analyze = "Sample text to test agent for agentcore evaluations demo"
payload = json.dumps({
"prompt": f"Can you analyze this text and tell me about its statistics: {text_to_analyze}"
})
# random session-id, you can set your own here
session_id = "test-ace-demo-session-18a1dba0-62a0-462g"
response = agent_core_client.invoke_agent_runtime(
agentRuntimeArn=ace_demo_agent_arn,
runtimeSessionId=session_id,
payload=payload,
qualifier="DEFAULT"
)
response_body = response['response'].read()
response_data = json.loads(response_body)
print("Agent Response:", response_data)
print("SessionId:", session_id)
```
## 第 3 步:评估代理
向代理发出了几次调用后,就可以对其进行评估了。为了进行评估,我们需要:
+ `EvaluatorId`: 这可以是内置评估器的 ID,也可以是自定义创建的
+ `SessionSpans`: span 是您与应用程序交互时发出的遥测块。我们示例中的应用程序是托管在 AgentCore Runtime 上的代理。
+ 对于按需评估,我们需要从 CloudWatch 日志组中下载跨度并将其用于评估。
+ **AgentCore C ** LI 会自动为您执行此操作,并且是最容易上手的。
+ 如果您不使用 AgentCore CLI,我们将展示如何使用会话 ID 下载日志,并使用 SDK 将其用于评估。 Amazon
**Topics**
+ [AgentCore CLI 和 AgentCore SDK 的代码示例](#agentcore-cli-evaluation)
+ [Amazon SDK](#aws-sdk-evaluation)
### AgentCore CLI 和 AgentCore SDK 的代码示例
以下代码示例演示如何使用不同的开发方法运行按需评估。选择最适合您的开发环境和偏好的方法。
**Example**
1.
```
# Runs evaluation for the specified runtime and session.
# It auto queries cloudwatch logs and orchestrates evaluation over multiple evaluators.
RUNTIME_NAME="your_runtime_name"
SESSION_ID="YOUR_SESSION_ID"
agentcore run eval \
--runtime $RUNTIME_NAME \
--session-id $SESSION_ID \
--evaluator "Builtin.Helpfulness" \
--evaluator "Builtin.GoalSuccessRate"
# Auto reads default runtime from current project config if available
# Verify using ```agentcore status```
agentcore run eval \
--evaluator "Builtin.Helpfulness" \
--evaluator "Builtin.GoalSuccessRate"
```
结果保存在本地,以后可以查看`agentcore evals history`。在交互模式下,CLI 会自动从中 CloudWatch 发现最近的会话,您无需事先知道会话 ID。
**注意**
在 AgentCore 项目目录(使用创建`agentcore create`)中运行它。该`--agent-arn`标志可以在项目目录之外使用。
1. 运行打开 `agentcore` TUI,然后选择**运行**并选择**On-demand 评估**:
1. 选择要针对代理跟踪运行的评估器:
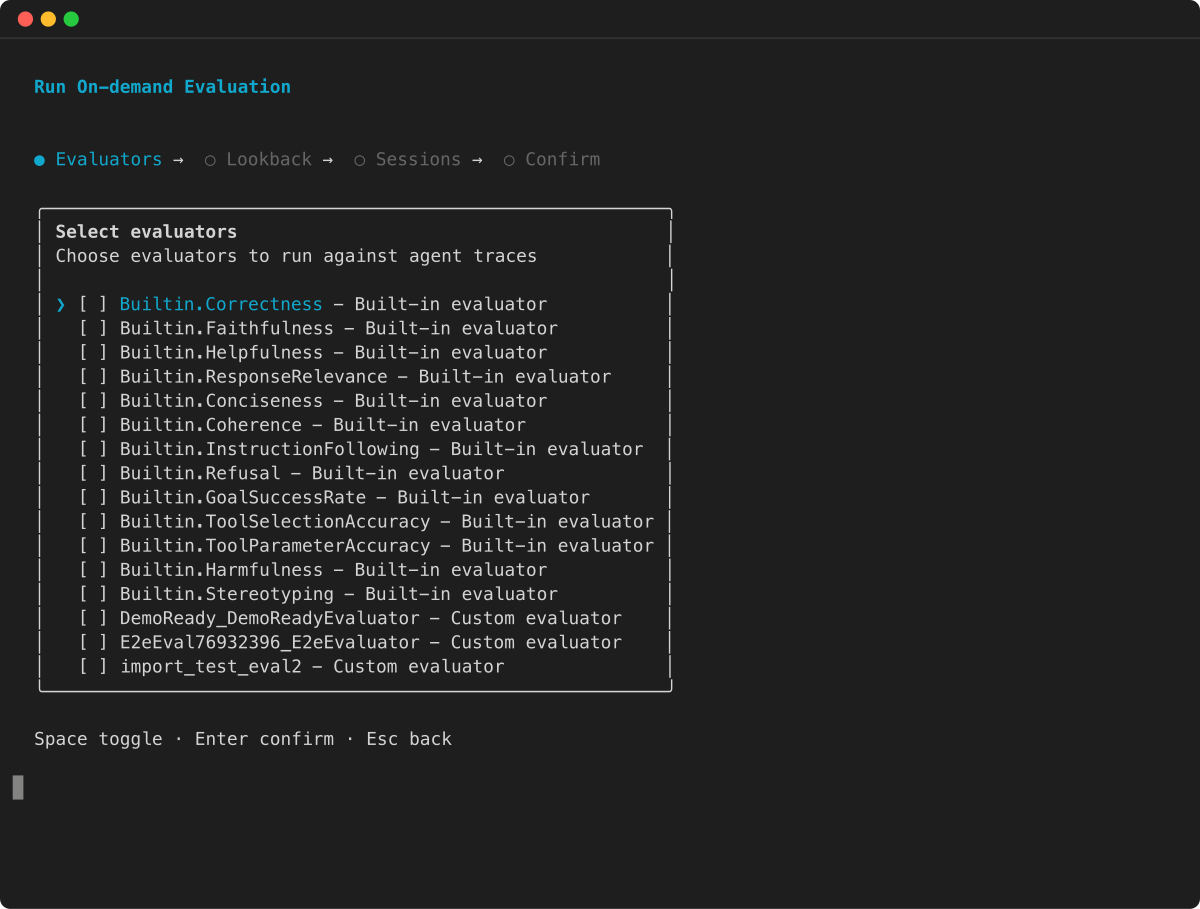
1. 查看配置并按 Enter 键确认:
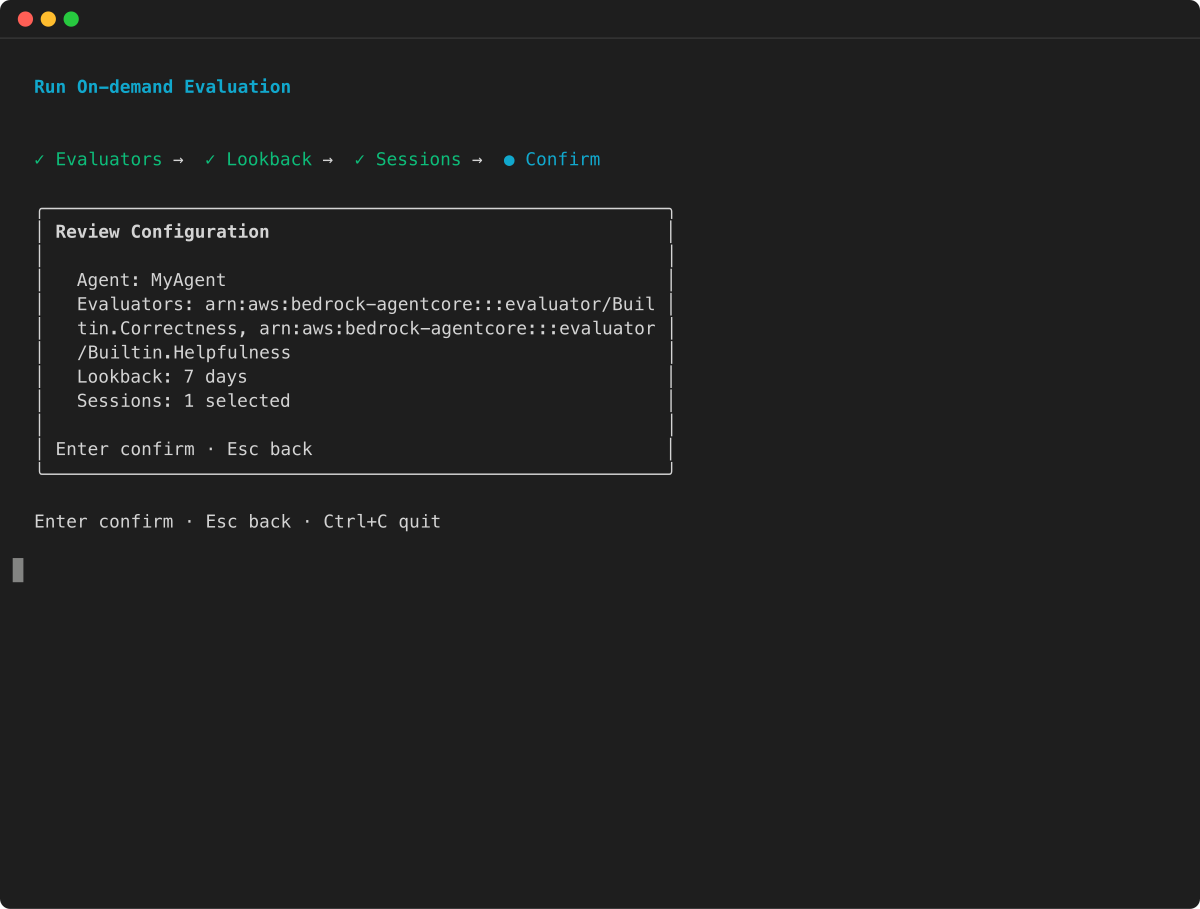
1.
```
from bedrock_agentcore_starter_toolkit import Evaluation
# Initialize the evaluation client
eval_client = Evaluation()
# Run evaluation on a specific session
results = eval_client.run(
agent_id="YOUR_AGENT_ID", # Replace with your agent ID
session_id="YOUR_SESSION_ID", # Replace with your session ID
evaluators=["Builtin.Helpfulness", "Builtin.GoalSuccessRate"]
)
# Display results
successful = results.get_successful_results()
failed = results.get_failed_results()
print(f" Successful: {len(successful)}")
print(f" Failed: {len(failed)}")
if successful:
result = successful[0]
print("\n📊 Result:")
print(f" Evaluator: {result.evaluator_name}")
print(f" Score: {result.value:.2f}")
print(f" Label: {result.label}")
if result.explanation:
print(f" Explanation: {result.explanation[:150]}...")
```
### Amazon SDK
**Topics**
+ [从下载跨度日志 CloudWatch](#download-span-logs)
+ [致电评估](#call-evaluate)
+ [使用评估目标](#using-evaluation-targets)
#### 从下载跨度日志 CloudWatch
在调用 `Evaluate` API 之前,您需要从下载跨度日志 CloudWatch。您可以使用下面的 Python 代码来执行此操作,也可以选择将它们保存在 JSON 文件中。这样可以更轻松地请求与不同的评估者进行同一个会话。
**注意**
填充日志需要几分钟 CloudWatch,因此,如果您尝试在代理调用后 “立即” 运行以下脚本,则日志可能为空或不完整
```
import boto3
import time
import json
from datetime import datetime, timedelta
region = "region-code"
agent_id = "agent-id-from-step-2"
session_id = "session-id-from-step-3"
def query_logs(log_group_name, query_string):
client = boto3.client('logs', region_name=region)
start_time = datetime.now() - timedelta(minutes=60) # past 1 hour
end_time = datetime.now()
query_id = client.start_query(
logGroupName=log_group_name,
startTime=int(start_time.timestamp()),
endTime=int(end_time.timestamp()),
queryString=query_string
)['queryId']
while (result := client.get_query_results(queryId=query_id))['status'] not in ['Complete', 'Failed']:
time.sleep(1)
if result['status'] == 'Failed':
raise Exception("Query failed")
return result['results']
def query_session_logs(log_group_name, session_id, **kwargs):
query = f"""fields @timestamp, @message
| filter ispresent(scope.name) and ispresent(attributes.session.id)
| filter attributes.session.id = "{session_id}"
| sort @timestamp asc"""
return query_logs(log_group_name, query, **kwargs)
def query_agent_runtime_logs(agent_id, endpoint, session_id, **kwargs):
return query_session_logs(
f"/aws/bedrock-agentcore/runtimes/{agent_id}-{endpoint}",
session_id, **kwargs)
def query_aws_spans_logs(session_id, **kwargs):
return query_session_logs("aws/spans", session_id, **kwargs)
def extract_messages_as_json(query_results):
return [json.loads(f['value']) for row in query_results
for f in row if f['field'] == '@message'
and f['value'].strip().startswith('{')]
def get_session_span_logs():
agent_runtime_logs = query_agent_runtime_logs(
agent_id=agent_id, endpoint="DEFAULT", session_id=session_id
)
print(f"Downloaded {len(agent_runtime_logs)} runtime-log entries")
aws_span_logs = query_aws_spans_logs(session_id=session_id)
print(f"Downloaded {len(aws_span_logs)} aws/span entries")
session_span_logs = extract_messages_as_json(aws_span_logs) + extract_messages_as_json(agent_runtime_logs)
print(f"Returning {len(aws_span_logs) + len(agent_runtime_logs)} total records")
return session_span_logs
# get the spans from cloudwatch
session_span_logs = get_session_span_logs()
# optional (dump in a json file for reuse)
session_span_logs_file_name = "ace-demo-session.json"
with open(session_span_logs_file_name, "w") as f:
json.dump(session_span_logs, f, indent=2)
```
#### 致电评估
一旦有了输入跨度,就可以调用 `Evaluate` API。请注意,回复可能需要一些时间,因为大型语言模型正在对您的踪迹进行评分。
```
# initialise client
ace_dp_client = boto3.client('bedrock-agentcore', region_name = region)
# call evaluate
response = ace_dp_client.evaluate(
evaluatorId = "Builtin.Helpfulness", # can be a custom evaluator id as well
evaluationInput = {"sessionSpans": session_span_logs})
print(response["evaluationResults"])
```
如果您使用上述方法并将会话跨度转储到 json 文件中,则随后也可以按如下方式运行评估
```
with open(session_span_logs_file_name, "r") as f:
session_span_logs = json.load(f)
# initialise client
ace_dp_client = boto3.client('bedrock-agentcore', region_name = region)
# call evaluate
response = ace_dp_client.evaluate(
evaluatorId = "Builtin.ToolSelectionAccuracy", # can be a custom evaluator id as well
evaluationInput = {"sessionSpans": session_span_logs})
print(response["evaluationResults"])
```
#### 使用评估目标
要评估会话中的特定跟踪或工具,您可以使用请求中的`evaluationTarget`参数指定目标。
**Topics**
+ [Session-level 评估员](#session-level-evaluator)
+ [Trace-level 评估员](#trace-level-evaluator)
+ [工具通话级别评估器](#tool-call-level-evaluator)
##### Session-level 评估员
由于该服务每次评估仅支持一个会话,因此您无需明确设置评估目标。
##### Trace-level 评估员
对于跟踪级别的赋值器(例如`Builtin.Helpfulness`或`Builtin.Correctness`),请在参数中设置跟踪 ID:`evaluationTarget`
```
response = ace_dp_client.evaluate(
evaluatorId = "Builtin.Helpfulness",
evaluationInput = {"sessionSpans": session_span_logs},
evaluationTarget = {"traceIds": ["trace-id-1", "trace-id-2"]}
)
```
##### 工具通话级别评估器
对于跨度级评估器(例如`Builtin.ToolSelectionAccuracy`),请在参数中设置跨度 ID:`evaluationTarget`
```
response = ace_dp_client.evaluate(
evaluatorId = "Builtin.ToolSelectionAccuracy",
evaluationInput = {"sessionSpans": session_span_logs},
evaluationTarget = {"spanIds": ["span-id-1", "span-id-2"]}
)
```
## 第 4 步:评估结果
每个 `Evaluate` API 调用都会返回一个包含评估器结果列表的响应。由于单个会话可以包含多个追踪和工具调用,因此将这些元素作为单独的实体进行评估。因此,单个 API 调用可能会返回多个评估结果。
```
{
"evaluationResults": [ {evaluation-result-1}, {evaluation-result_2},.... ]
}
```
**Topics**
+ [结果限制](#result-limit)
+ [部分故障](#partial-failures)
+ [跨度上下文](#span-context)
+ [成功输入结果示例](#example-successful-result)
+ [结果输入失败的示例](#example-failed-result)
### 结果限制
每次 API 调用返回的评估数量限制为 10 个结果。例如,如果您使用跟踪级别赋值器对包含 15 个跟踪的会话进行评估,则响应最多包含 10 个结果。默认情况下,API 返回最近 10 次评估,因为这些评估通常包含与评估质量相关的大多数上下文。
### 部分故障
一个 API 调用可以处理 n 个评估,而其中 m 个会失败。故障可能由于各种原因而发生,包括:
+ 来自模型提供商的限制
+ 解析错误
+ 模型超时
+ 其他处理问题
在部分失败的情况下,响应包括成功和失败的评估。失败的结果包括错误代码和错误消息,可帮助您诊断问题。
### 跨度上下文
每个评估器结果都有一个用于标识被评估实体的`spanContext`字段:
+ 对于会话级别的评估者,只有`sessionId`在场。
+ 适用于跟踪级别的评估人员,`sessionId`并且`traceId`在场。
+ 对于工具级评估器,`sessionId``traceId`、和`spanId`都存在。
### 成功输入结果示例
这只是一个条目。如果一个会话有多个跟踪,您将看到多个这样的条目,每个跟踪记录一个。同样,对于工具级评估器,如果有多个工具调用并且提供了一个工具评估器(例如`Builtin.ToolSelectionAccuracy`),则每个工具跨度将有一个结果。
```
{
"evaluatorArn": "arn:aws:bedrock-agentcore:::evaluator/Builtin.Helpfulness",
"evaluatorId": "Builtin.Helpfulness",
"evaluatorName": "Builtin.Helpfulness",
"explanation": ".... evaluation explanation will be added here ...",
"context": {
"spanContext": {
"sessionId": "test-ace-demo-session-18a1dba0-62a0-462e",
"traceId": "....trace_id......."
}
},
"value": 0.83,
"label": "Very Helpful",
"tokenUsage": {
"inputTokens": 958,
"outputTokens": 211,
"totalTokens": 1169
}
}
```
### 结果输入失败的示例
```
{
"evaluatorArn": "arn:aws:bedrock-agentcore:::evaluator/Builtin.Helpfulness",
"evaluatorId": "Builtin.Helpfulness",
"evaluatorName": "Builtin.Helpfulness",
"context": {
"spanContext": {
"sessionId": "test-ace-demo-session-18a1dba0-62a0-462e",
"traceId": "....trace_id......."
}
},
"errorMessage": ".... details of the error....",
"errorCode": ".... name/code of the error...."
}
```