**帮助改进此页面**
要帮助改进本用户指南,请选择位于每个页面右侧窗格中的**在 GitHub 上编辑此页面**链接。
# 使用 CLI 为人工智能/机器学习工作负载设置 Amazon EKS 集群
**提示**
[注册参加](https://events.eksworkshop.com/workshops/genai/)即将举办的 Amazon EKS 人工智能/机器学习讲习会。
本节将演示通过 CLI 命令创建在 Amazon EKS 上运行训练或推理工作负载所需基础设施的步骤。这些步骤包括创建一个 EKS 集群、若干使用 EKS 自动模式或 Karpenter 的 GPU 节点、一个使用 Prometheus 和 Grafana 的监控堆栈以及用于存储模型权重的 Amazon S3 存储。
有关这些功能如何在 EKS 集群中预调配和自动扩展 EC2 实例的更多信息,请参阅 [EKS 自动模式](https://docs.amazonaws.cn/eks/latest/userguide/automode.html)和 [Karpenter](https://karpenter.sh/docs/) 文档。
**高层架构和工作流**
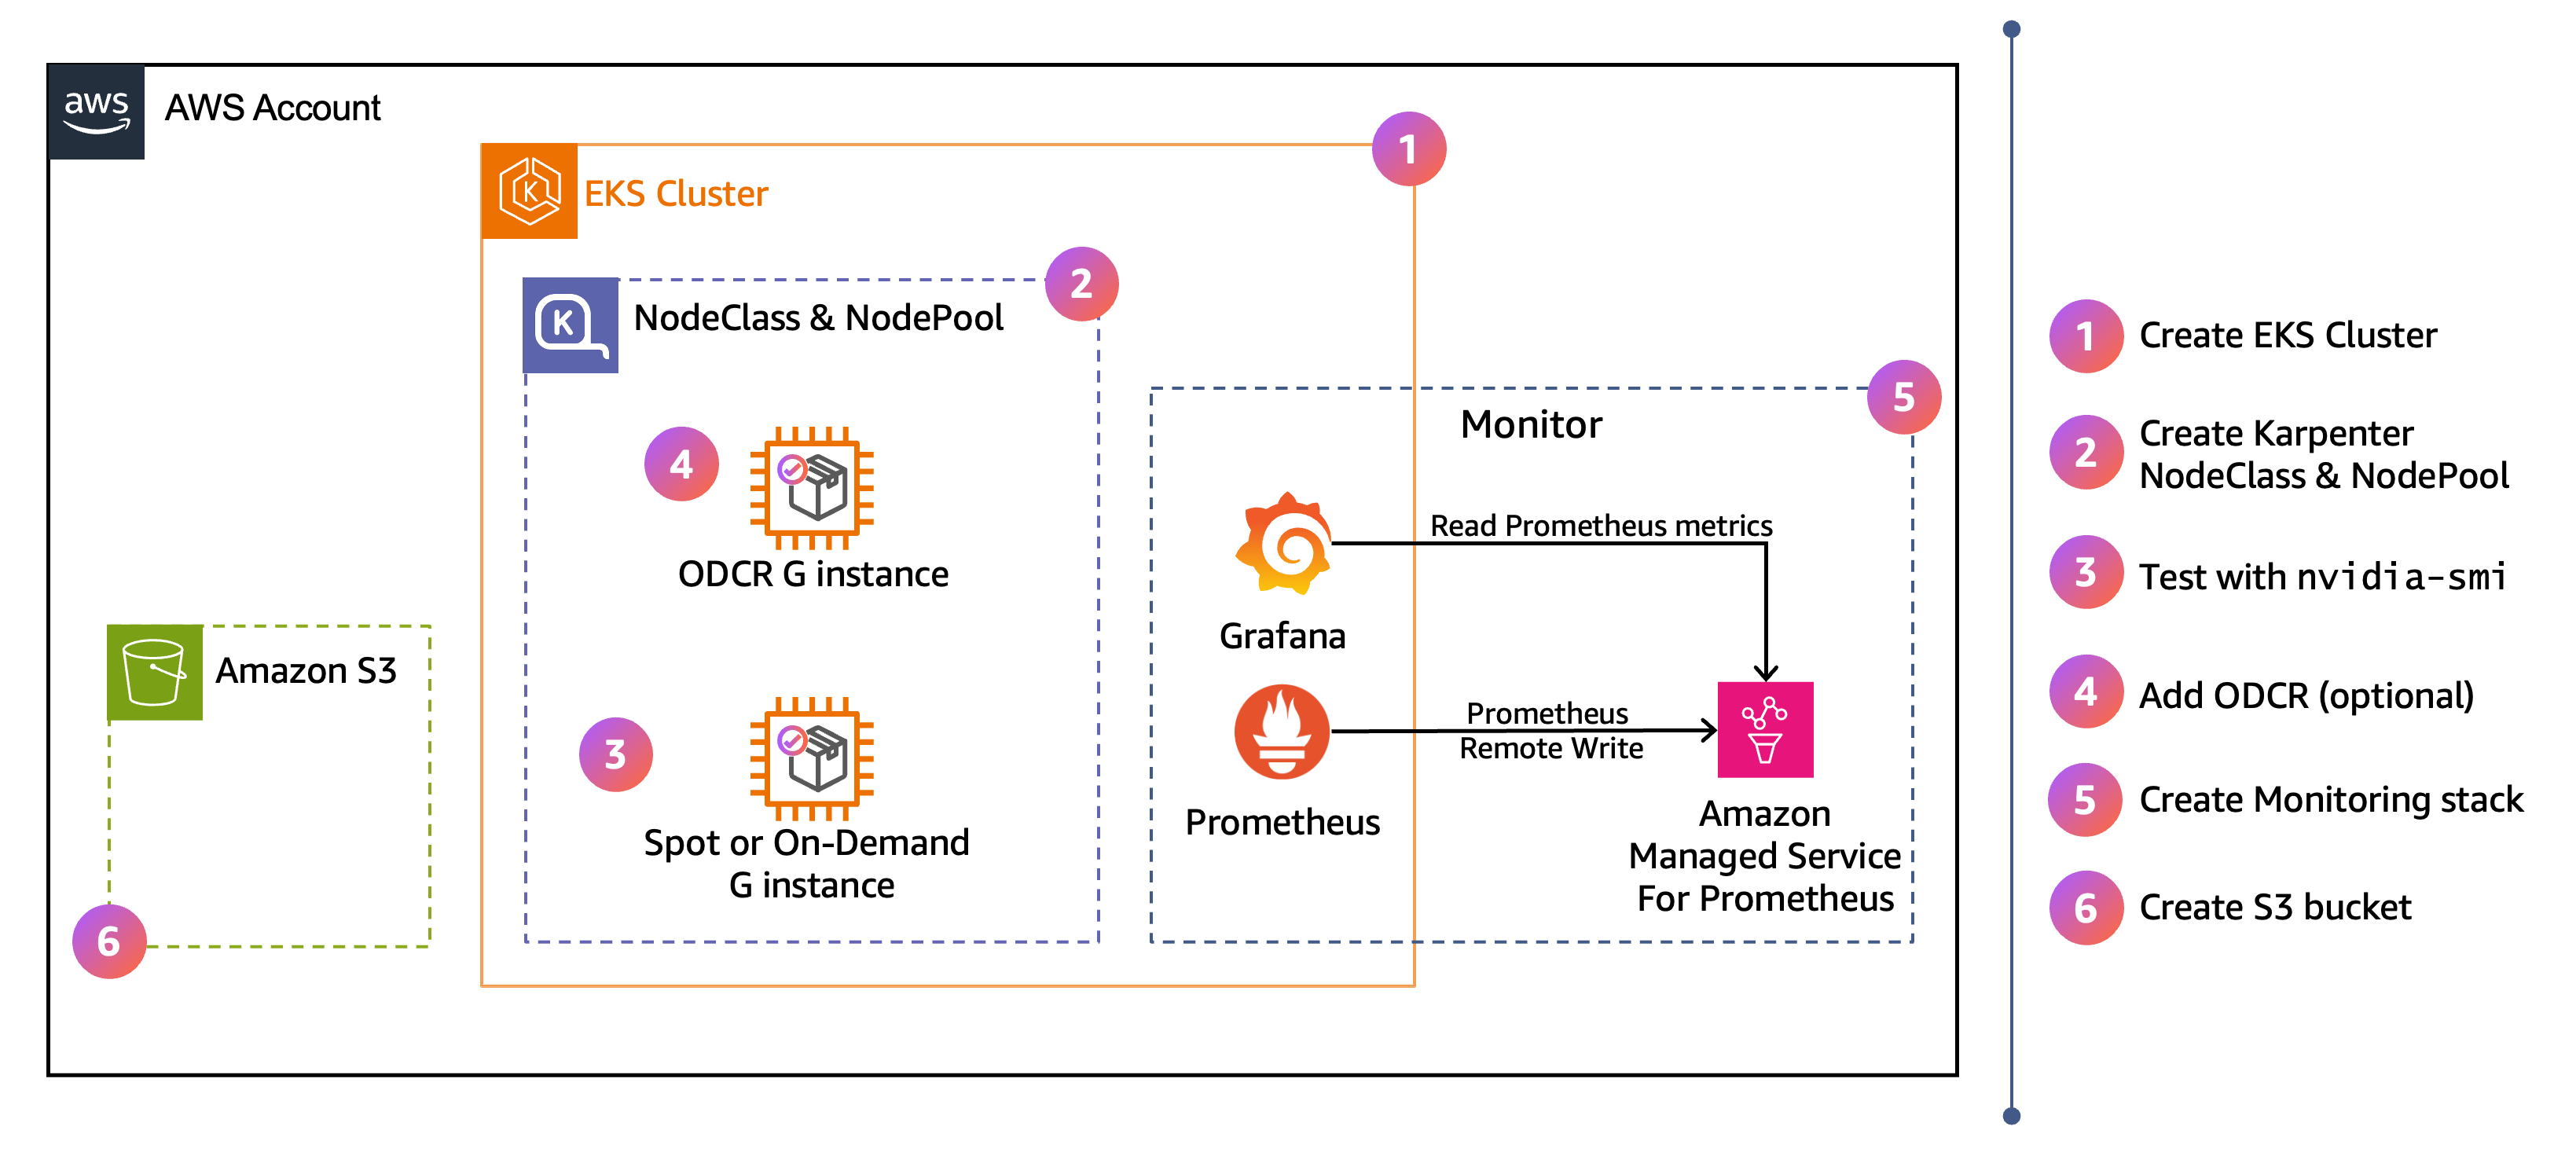
下图显示了本节设置的 Amazon 高层架构。右侧带编号的步骤表示您按以下步骤完成配置的顺序。
## 先决条件
+ `kubectl` >= 1.35。有关设置说明,请参阅[设置 `kubectl` 和 `eksctl`](install-kubectl.md)。
+ Amazon CLI >= 2.27。有关设置说明,请参阅[安装](https://docs.amazonaws.cn/cli/latest/userguide/cli-chap-install.html)。
+ Helm >= 3.14。有关设置说明,请参阅[设置 Helm](helm.md)。
+ `jq`。有关设置说明,请参阅 [Download jq](https://jqlang.github.io/jq/download/)。
+ `eksctl` >= 0.227.0。有关设置说明,请参阅 `eksctl` 文档中的 [Installation](https://eksctl.io/installation)。
验证您的 `eksctl` 版本:
```
eksctl version
```
如果您使用的版本早于 0.227.0,请按照 [eksctl 安装指南](https://eksctl.io/installation/)升级到最新版本。
## 设置环境变量
在这些步骤中,以下集群名称和 Amazon 区域应保持一致。如果更改则可能会导致后续命令使用的目标 EKS 集群不正确。
```
export CLUSTER_NAME=ai-eks-docs
export AWS_REGION=us-east-2
```
使用所有可用的可用区可提高容错能力并增加获得 GPU 容量的机会:
```
export AZS=$(aws ec2 describe-availability-zones \
--region ${AWS_REGION} \
--query "AvailabilityZones[?ZoneId!='use1-az3' && ZoneId!='usw1-az2' && ZoneId!='cac1-az3'].ZoneName" \
--output text | tr '\t' ',')
echo $AZS
```
**重要**
应排除 `use1-az3`、`usw1-az2` 和 `cac1-az3` 可用区,因为 [Amazon EKS 不支持将控制面板置于这些可用区中](https://repost.aws/knowledge-center/eks-cluster-creation-errors)。使用其中任何一个可用区中的子网创建集群都会导致 `UnsupportedAvailabilityZoneException` 错误。
预期输出:
```
us-east-2a,us-east-2b,us-east-2c
```
输出中的可用区因区域而异。此示例显示的是 `us-east-2` 区域的可用区。
## 创建集群和 GPU 节点池
本节提供了两种创建 EKS 集群和 GPU 节点的路径,如下图所示。在整个指南中请仅选择一个选项。
+ **EKS 自动模式**:除了核心的[联网、存储和负载均衡附加组件](https://docs.amazonaws.cn/eks/latest/userguide/eks-add-ons.html#addon-consider-auto)外,EKS 自动模式还会包括并管理下列用于训练和推理工作负载的功能:EKS 节点监控代理、自动节点修复、用于快速提取容器的 [SOCI](https://github.com/awslabs/soci-snapshotter) 快照拍摄器,并为默认节点类准备好 GPU。NVIDIA 设备插件包含在EKS 自动模式用于 GPU 节点的 Bottlerocket 加速型 AMI 中。
+ **自行管理的 Karpenter**:对于不使用 EKS 自动模式的 EKS 集群,您负责安装和配置训练和推理工作负载所需的组件。这包括联网附加组件(VPC CNI、CoreDNS、kube-proxy)、Karpenter、EKS 节点监控代理、NVIDIA 设备插件和用于快速提取容器的 SOCI 快照拍摄器。
**EKS 集群选项:EKS 自动模式和自行管理的 Karpenter**
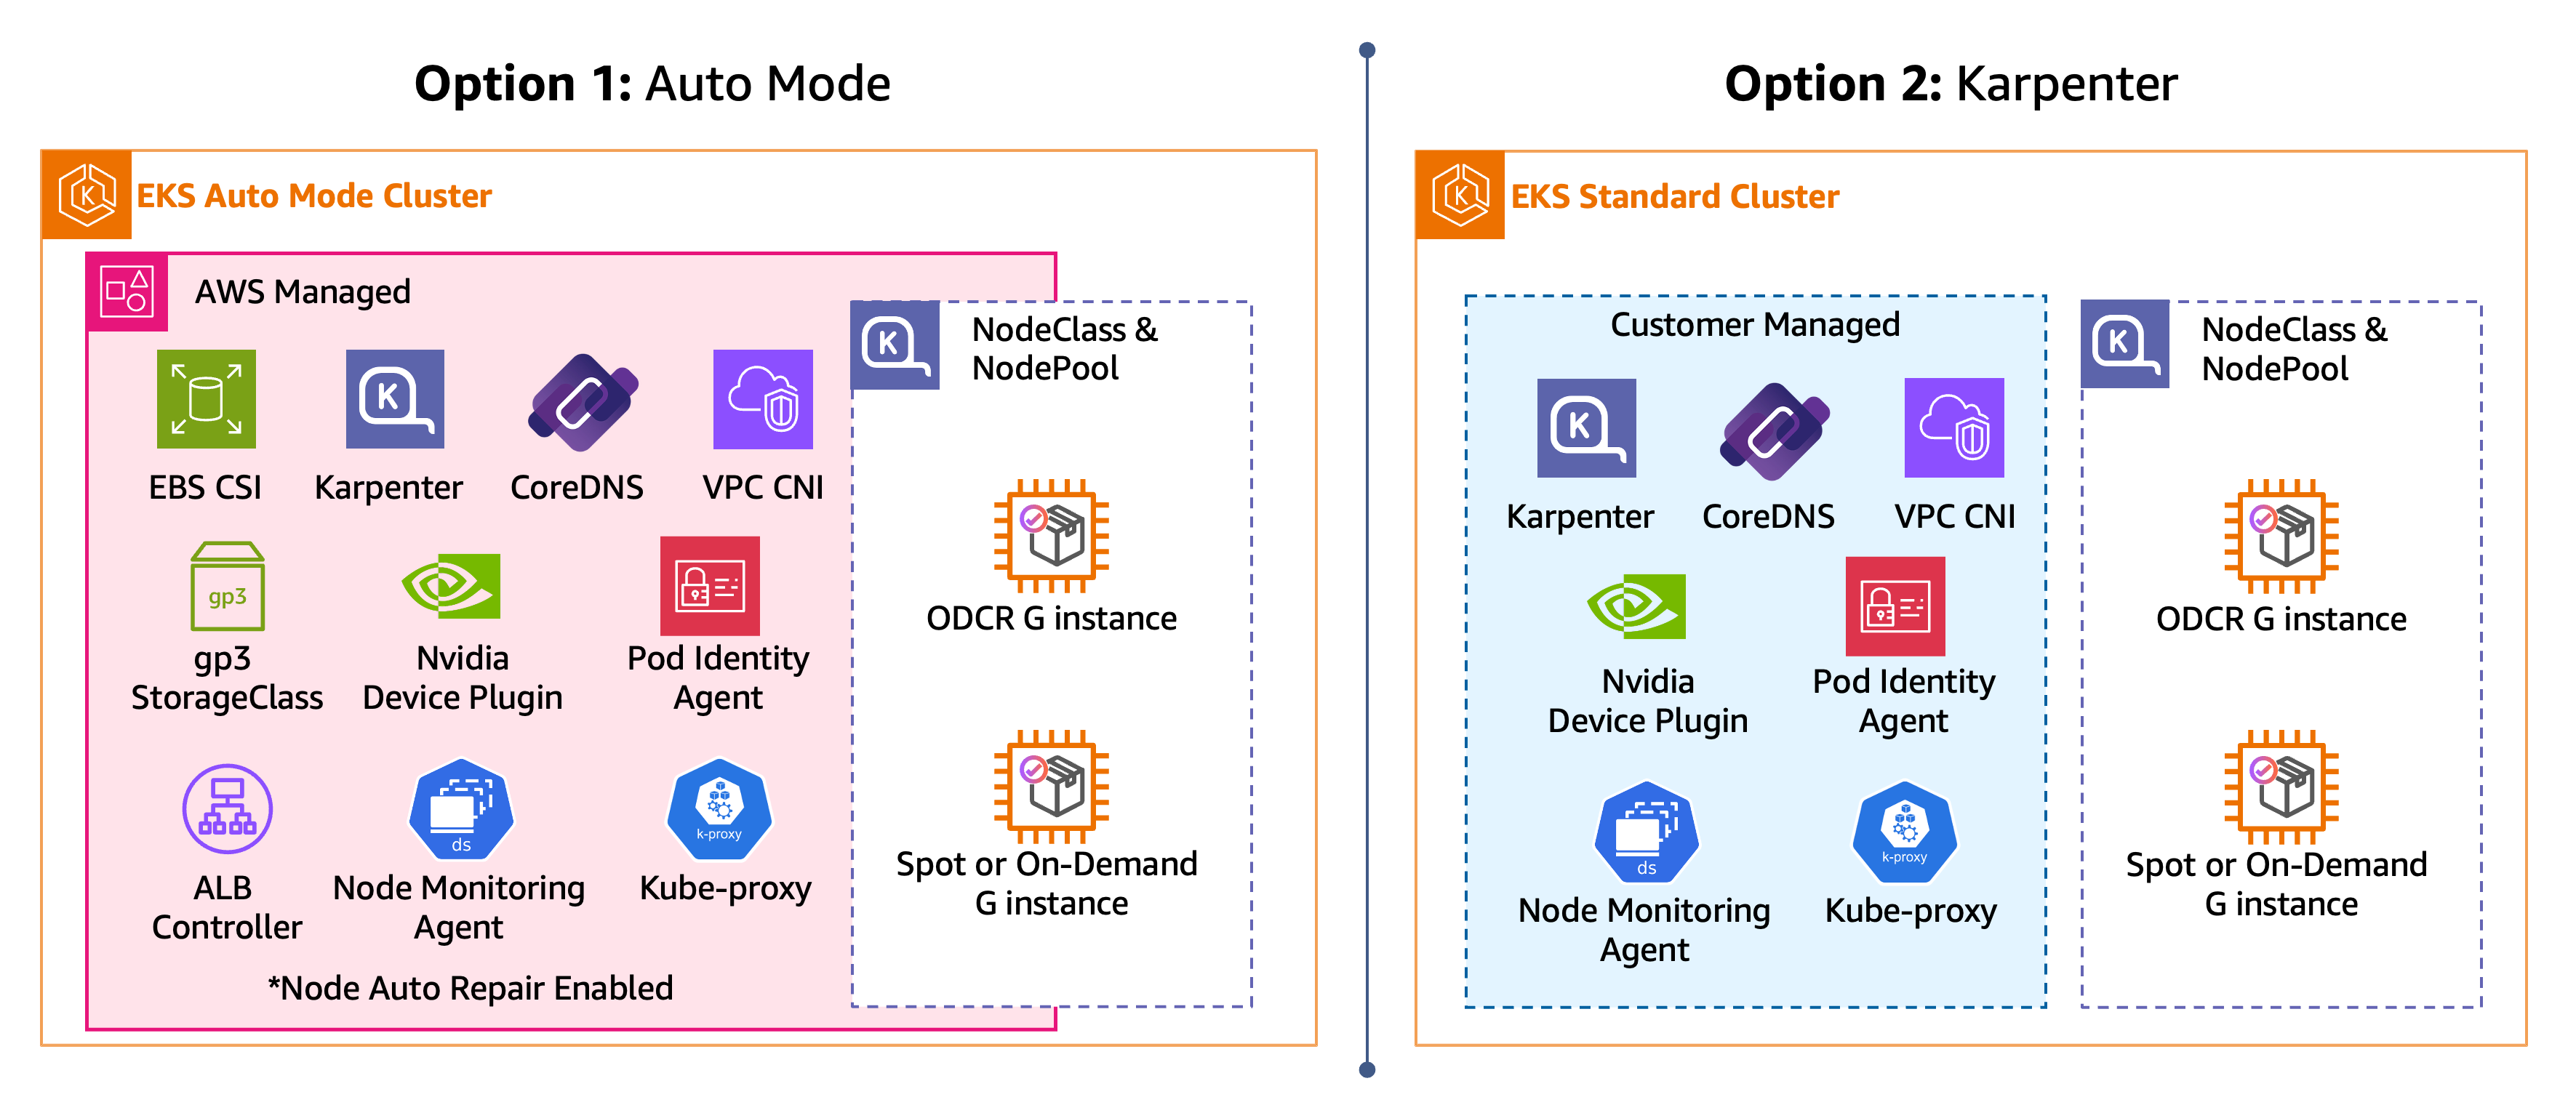
在以下每个步骤中,选择一条路径(EKS 自动模式、Karpenter),然后全程遵循该路径。完成所选路径的步骤后,您将获得一个具有 GPU 节点池,可随时用于调度 GPU 工作负载的 EKS 集群。
## 第 1 步:创建集群
首先创建 EKS 集群并安装 GPU 工作负载所需的集群组件。
使用 EKS 自动模式时,只需一条 `eksctl create cluster --enable-auto-mode` 命令即可预调配一个可随时用于 GPU 工作负载的 EKS 集群。
使用自行管理的 Karpenter 时,`eksctl create cluster` 命令会预调配核心联网附加组件,然后您需要完成其他步骤以通过 Karpenter 特定门控启用自动节点修复功能、安装 EKS 节点监控代理并安装 NVIDIA 设备插件。
------
#### [ EKS Auto Mode ]
**创建 EKS 自动模式集群**
```
eksctl create cluster \
--name=$CLUSTER_NAME \
--region=$AWS_REGION \
--enable-auto-mode \
--version=1.35 \
--zones=$AZS
```
此命令可能需要几分钟才能完成。完成后,`eksctl` 会自动更新您的 kubeconfig 文件以用于新预调配的集群。验证集群是否能够正常运行:
```
kubectl get pods --all-namespaces
```
预期输出:
```
NAMESPACE NAME READY STATUS RESTARTS AGE
kube-system metrics-server-55cf976ddd-cz2mw 1/1 Running 0 3m
kube-system metrics-server-55cf976ddd-wrjvv 1/1 Running 0 3m
```
在 EKS 自动模式下,VPC CNI、kube-proxy 和 CoreDNS 作为托管式组件运行,不会在 `kube-system` 中作为容器组出现。
------
#### [ Self-managed Karpenter ]
**通过公共 ECR 进行 Helm 身份验证**
`eksctl` 会从 Amazon 公共 ECR 中提取 Karpenter Helm 图表。请在创建集群之前完成身份验证,以避免在 Helm 安装步骤中出现 403 错误:
```
aws ecr-public get-login-password --region us-east-1 \
| helm registry login --username AWS --password-stdin public.ecr.aws
```
公共 ECR 是一项在 `us-east-1` 中托管的全球服务。无论您的 EKS 集群位于哪个区域,此处都应使用 `--region us-east-1`。
预期输出:`Login Succeeded`
**创建使用 Karpenter 的 EKS 集群**
将您的 Karpenter 版本存储在环境变量中以备以后使用。要了解最新的 Karpenter 版本,请参阅 GitHub 上的 [Karpenter releases](https://github.com/aws/karpenter-provider-aws/releases)。
```
export KARPENTER_VERSION=1.12.0
```
### 集群 config YAML 和 `eksctl create cluster`
```
cat << EOF > /tmp/cluster-karpenter.yaml
apiVersion: eksctl.io/v1alpha5
kind: ClusterConfig
metadata:
name: ${CLUSTER_NAME}
region: ${AWS_REGION}
version: "1.35"
tags:
karpenter.sh/discovery: ${CLUSTER_NAME}
availabilityZones: [$(echo $AZS | sed 's/,/, /g')]
autoModeConfig:
enabled: false
iam:
withOIDC: true
karpenter:
version: "${KARPENTER_VERSION}"
withSpotInterruptionQueue: true
managedNodeGroups:
- name: system
instanceType: m6i.2xlarge
desiredCapacity: 2
minSize: 2
maxSize: 3
labels:
node-role: system
tags:
karpenter.sh/discovery: ${CLUSTER_NAME}
addons:
- name: eks-pod-identity-agent
- name: eks-node-monitoring-agent
EOF
eksctl create cluster -f /tmp/cluster-karpenter.yaml
```
此命令大约需要 15 分钟才能完成。此命令会创建一个 EKS 集群,其中包含一个专用于托管附加组件和 Karpenter 控制器的托管式节点组。Karpenter 在安装时已启用竞价型实例中断排队功能,因此可以处理竞价型实例中断和再平衡建议。`autoModeConfig.enabled: false` 设置显式规定该集群不使用 EKS 自动模式,因此在此路径中安装的 Karpenter 组件会负责节点管理。
该集群还会将 [EKS 容器组身份代理](https://docs.amazonaws.cn/eks/latest/userguide/pod-identities.html)和 [EKS 节点监控代理](https://docs.amazonaws.cn/eks/latest/userguide/node-health.html)安装为 EKS 附加组件。本指南的后面部分将会使用 EKS 容器组身份。EKS 节点监控代理将在每个节点上运行,并读取内核日志以设置节点条件(例如 `AcceleratedHardwareReady`、`KernelReady` 和 `NetworkingReady`)。Karpenter 自动节点修复功能将使用这些节点条件来决定何时替换运行不正常的节点。
验证集群是否能够正常运行:
```
kubectl get pods --all-namespaces
```
预期输出包括 Karpenter、CoreDNS、kube-proxy、aws-node(VPC CNI)、EKS 容器组身份代理和 EKS 节点监控代理。
```
NAMESPACE NAME READY STATUS RESTARTS AGE
karpenter karpenter-567547464c-s6vkx 1/1 Running 0 3m40s
karpenter karpenter-567547464c-x7gmw 1/1 Running 0 3m40s
kube-system aws-node-b6gf2 2/2 Running 0 12m
kube-system aws-node-lcphh 2/2 Running 0 12m
kube-system coredns-7d4dcbf4fb-ccvrr 1/1 Running 0 16m
kube-system coredns-7d4dcbf4fb-qbhk2 1/1 Running 0 16m
kube-system eks-node-monitoring-agent-h79vm 1/1 Running 0 9m45s
kube-system eks-node-monitoring-agent-tf4dw 1/1 Running 0 9m45s
kube-system eks-pod-identity-agent-5jbtc 1/1 Running 0 12m
kube-system eks-pod-identity-agent-rwcrc 1/1 Running 0 12m
kube-system kube-proxy-p4bmq 1/1 Running 0 12m
kube-system kube-proxy-v5nwr 1/1 Running 0 12m
kube-system metrics-server-5b966ff79c-hr58p 1/1 Running 0 9m22s
kube-system metrics-server-5b966ff79c-szs2d 1/1 Running 0 9m22s
```
**启用自动节点修复**
EKS 自动模式会默认启用自动节点修复功能。在自行管理的 Karpenter 上,自动节点修复功能位于 `NodeRepair=true` 特性门控之后,必须显式启用。以下命令将为 Karpenter 部署安装补丁程序以添加 `NodeRepair=true` 特性门控。更新部署环境会触发 Karpenter 容器组的逐步部署:
```
kubectl set env deployment/karpenter -n karpenter \
FEATURE_GATES=NodeRepair=true
```
预期输出:
```
deployment.apps/karpenter env updated
```
等待 Karpenter 容器组逐步部署:
```
kubectl rollout status deployment/karpenter -n karpenter
```
**安装 NVIDIA 设备插件**
EKS 优化版 AL2023 AMI 不包含 [NVIDIA 设备插件](https://github.com/NVIDIA/k8s-device-plugin)(与 EKS 自动模式使用的 Bottlerocket AMI 不同)。请通过 Helm 安装此插件,确保 GPU 资源可用于集群上的容器组。
```
helm repo add nvdp https://nvidia.github.io/k8s-device-plugin
helm repo update
```
```
cat << 'EOF' > /tmp/nvdp-values.yaml
mofedEnabled: false
nodeSelector:
amiFamily: al2023
gfd:
enabled: true
nfd:
worker:
tolerations:
- operator: "Exists"
EOF
```
```
helm install nvidia-device-plugin nvdp/nvidia-device-plugin \
--namespace kube-system \
-f /tmp/nvdp-values.yaml
```
+ `mofedEnabled: false`:禁用 Mellanox OFED(InfiniBand)检查,Amazon 不使用此检查
+ `nodeSelector.amiFamily: al2023`:将 DaemonSet 范围限定为仅限 AL2023 节点(Bottlerocket 已经内置了此插件)
+ `gfd.enabled: true`:启用 GPU 功能发现标签(`nvidia.com/gpu.product`、`nvidia.com/gpu.memory` 等)
验证是否已安装 NVIDIA 设备插件。预期结果是在预调配具有匹配标签的 GPU 节点池之前,设备插件容器组数量为零。
```
kubectl get daemonset nvidia-device-plugin -n kube-system
```
预期输出:
```
NAME DESIRED CURRENT READY UP-TO-DATE AVAILABLE NODE SELECTOR AGE
nvidia-device-plugin 0 0 0 0 0 amiFamily=al2023 2m5s
```
------
**警告**
无论是 EKS 自动模式路径还是自行管理的 Karpenter 路径,对于由节点池预调配的节点,自动节点修复功能的行为方式是相同的。EKS 自动模式和 Karpenter 中的自动节点修复是一种*强制*中断方法,可以绕过容器组中断预算、`karpenter.sh/do-not-disrupt` 注释和 `terminationGracePeriod`。自动节点修复需要等待 10 分钟,然后才会替换 `AcceleratedHardwareReady` 条件设置为 `False` 的节点;对于[其他修复条件](https://docs.amazonaws.cn/eks/latest/userguide/node-repair.html),则需要等待 30 分钟。
## 第 2 步:创建动态 GPU 节点池
定义一个将使用竞价型容量动态预调配 4 代以上 G 系列 GPU 实例,并以按需型实例为备用容量的节点池。EKS 自动模式和 Karpenter 路径都使用相同的节点池 API,唯一区别是所指向的节点类不同。使用 EKS 自动模式时,捆绑的 `default` 节点类已经选择了正确的 AMI 并配置了 SOCI 并行拉取,因此您唯一需要创建的对象是节点池。使用自行管理的 Karpenter 时,您还需要一个可以固定 AMI 并微调 SOCI 的自定义 `EC2NodeClass`。
------
#### [ EKS Auto Mode ]
使用 EKS 自动模式时,捆绑的 `default` 节点类会自动选择适用于 GPU 实例的 Bottlerocket AMI,其中包括预装的 NVIDIA 驱动程序、NVIDIA 设备插件和 SOCI 并行拉取。您只需要应用一个引用 `default` 节点类的节点池即可:
```
cat << 'EOF' | kubectl apply -f -
apiVersion: karpenter.sh/v1
kind: NodePool
metadata:
name: gpu-inf
spec:
template:
metadata:
labels:
guide: ai-eks-docs
spec:
nodeClassRef:
group: eks.amazonaws.com
kind: NodeClass
name: default
taints:
- key: nvidia.com/gpu
effect: NoSchedule
requirements:
- key: karpenter.sh/capacity-type
operator: In
values: ["spot", "on-demand"]
- key: eks.amazonaws.com/instance-category
operator: In
values: ["g"]
- key: eks.amazonaws.com/instance-generation
operator: Gt
values: ["4"]
- key: kubernetes.io/arch
operator: In
values: ["amd64"]
limits:
cpu: 1000
memory: 5000Gi
EOF
```
此节点池会预调配 4 代以上 G 系列 GPU 实例([G5](https://www.amazonaws.cn/ec2/instance-types/g5/)、[G6e](https://www.amazonaws.cn/ec2/instance-types/g6e/)、[G7e](https://www.amazonaws.cn/ec2/instance-types/g7e/)等)。`nvidia.com/gpu:NoSchedule` 污点可确保仅在这些节点上调度符合 GPU 启用条件的容器组。
------
#### [ Self-managed Karpenter ]
自行管理的 Karpenter 不包含默认的节点类。您需要首先创建一个 `EC2NodeClass`,用来固定 EKS 优化版 NVIDIA AL2023 AMI 别名、通过 `FastImagePull` 特性门控启用 SOCI,并配置 `instanceStorePolicy: RAID0` 以将 containerd 映像缓存移到本地 NVMe 中。然后您需要创建引用该节点类的节点池。
**创建 EC2NodeClass**
### EC2NodeClass YAML
```
cat << EOF | kubectl apply -f -
apiVersion: karpenter.k8s.aws/v1
kind: EC2NodeClass
metadata:
name: gpu-inf
labels:
guide: ai-eks-docs
spec:
role: "eksctl-KarpenterNodeRole-${CLUSTER_NAME}"
amiSelectorTerms:
- alias: al2023@latest
subnetSelectorTerms:
- tags:
karpenter.sh/discovery: ${CLUSTER_NAME}
securityGroupSelectorTerms:
- tags:
karpenter.sh/discovery: ${CLUSTER_NAME}
tags:
karpenter.sh/discovery: ${CLUSTER_NAME}
instanceStorePolicy: RAID0
userData: |
MIME-Version: 1.0
Content-Type: multipart/mixed; boundary="BOUNDARY"
--BOUNDARY
Content-Type: application/node.eks.aws
---
apiVersion: node.eks.aws/v1alpha1
kind: NodeConfig
spec:
featureGates:
FastImagePull: true
containerd:
config: |
[plugins."io.containerd.snapshotter.v1.soci"]
[plugins."io.containerd.snapshotter.v1.soci".blob]
max_concurrent_downloads_per_image = 20
concurrent_download_chunk_size = "16mb"
max_concurrent_unpacks_per_image = 12
discard_unpacked_layers = true
--BOUNDARY--
EOF
```
`instanceStorePolicy: RAID0` 会将本地 NVMe 磁盘组装到 RAID-0 阵列中。`al2023@latest` AMI 别名会解析为 EKS 优化版 AL2023 AMI。当 Karpenter 启动 GPU 实例类型时,将会自动选择 AL2023\_x86\_64\_NVIDIA 加速型变体,其中包含预装的 NVIDIA 驱动程序。
`FastImagePull` 特性门控会启用 SOCI 快照拍摄器并行拉取模式,从而并发下载和解压缩映像层。这与 G、P 和 Trn 实例系列上的 EKS 自动模式行为一致。`containerd.config` 数据块会微调 ECR 托管映像的 SOCI 快照拍摄器:
+ `max_concurrent_downloads_per_image: 20` 允许每个映像并行下载不超过 20 层。Bottlerocket 上的默认值为 3 层,AL2023 上的默认值为 20 层。适用于 ECR 的建议值。
+ `concurrent_download_chunk_size: "16mb"` 会将每层分解成通过 HTTP 范围请求并行下载的 16 MB 块。建议用于支持范围 GET 的注册表(ECR 支持此功能)。
+ `max_concurrent_unpacks_per_image: 12` 一次最多可解压缩 12 层。Bottlerocket 上的默认值为 1 层,AL2023 上的默认值为 12 层。
+ `discard_unpacked_layers: true` 会在解压缩后删除压缩的层 blob 以节省磁盘空间。
要了解其他 SOCI 微调选项(每映像并发下载数、区块大小等),请参阅 [Karpenter SOCI blueprint](https://github.com/aws-samples/karpenter-blueprints/tree/main/blueprints/soci-snapshotter)。
验证 EC2NodeClass:
```
kubectl get ec2nodeclass gpu-inf
```
预期输出:`READY True`。如果为 `False`,请运行 `kubectl describe ec2nodeclass gpu-inf` 并检查缺少子网或安全组标签的情况。
**创建 GPU 节点池**
### 节点池 YAML
```
cat << EOF | kubectl apply -f -
apiVersion: karpenter.sh/v1
kind: NodePool
metadata:
name: gpu-inf
spec:
template:
metadata:
labels:
guide: ai-eks-docs
amiFamily: al2023
spec:
nodeClassRef:
group: karpenter.k8s.aws
kind: EC2NodeClass
name: gpu-inf
taints:
- key: nvidia.com/gpu
effect: NoSchedule
requirements:
- key: karpenter.sh/capacity-type
operator: In
values: ["spot", "on-demand"]
- key: karpenter.k8s.aws/instance-category
operator: In
values: ["g"]
- key: karpenter.k8s.aws/instance-generation
operator: Gt
values: ["4"]
- key: kubernetes.io/arch
operator: In
values: ["amd64"]
limits:
cpu: 1000
memory: 5000Gi
EOF
```
节点模板上的 `amiFamily: al2023` 标签正是 NVIDIA 设备插件 DaemonSet 用来选择这些节点的标签。
------
验证该节点池是否已创建:
```
kubectl get nodepool gpu-inf
```
预期输出:
```
NAME NODECLASS NODES READY AGE
gpu-inf default 0 True 8s
```
对于自行管理的 Karpenter 路径,NODECLASS 列将会显示 `gpu-inf`,而不是 `default`。
## 第 3 步:使用示例容器组进行测试
使用一个 `nvidia-smi` 容器组测试 GPU 节点池设置。
```
cat << EOF | kubectl apply -f -
apiVersion: v1
kind: Pod
metadata:
name: nvidia-smi
labels:
guide: ai-eks-docs
spec:
tolerations:
- key: "nvidia.com/gpu"
operator: "Exists"
effect: "NoSchedule"
containers:
- name: nvidia-smi
image: public.ecr.aws/amazonlinux/amazonlinux:2023-minimal
command: ["nvidia-smi"]
resources:
limits:
nvidia.com/gpu: 1
restartPolicy: OnFailure
EOF
```
验证容器组是否已成功调度并完成。
```
kubectl get pods
```
预期输出:
```
NAME READY STATUS RESTARTS AGE
nvidia-smi 0/1 Completed 0 67s
```
若状态为“已完成”,则表示 nvidia-smi 命令已完成运行并已退出。检查容器组日志,以查看节点检测到的 GPU。
```
kubectl logs nvidia-smi
```
预期输出:
```
+-----------------------------------------------------------------------------------------+
| NVIDIA-SMI 580.126.09 Driver Version: 580.126.09 CUDA Version: 13.0 |
+-----------------------------------------+------------------------+----------------------+
| GPU Name Persistence-M | Bus-Id Disp.A | Volatile Uncorr. ECC |
| Fan Temp Perf Pwr:Usage/Cap | Memory-Usage | GPU-Util Compute M. |
| | | MIG M. |
|=========================================+========================+======================|
| 0 NVIDIA RTX PRO 6000 Blac... On | 00000000:2B:00.0 Off | 0 |
| N/A 30C P0 81W / 600W | 0MiB / 97887MiB | 0% Default |
| | | Disabled |
+-----------------------------------------+------------------------+----------------------+
```
输出会显示 GPU 型号、驱动程序版本、CUDA 版本以及可用内存。在此示例中,Karpenter 预调配了一个 G7e 实例。该实例具有一个 NVIDIA RTX PRO 6000 Blackwell GPU 和 96 GB 内存。30C 表示当前 GPU 温度,P0 表示 GPU 处于最高性能状态(空闲但已就绪)。81W/600W 分别指当前功耗与最大功率容量,0miB/97887MiB 分别指当前使用的 GPU 内存与可用总内存。由于容器组刚刚运行完 nvidia-smi 并退出,因此没有工作负载使用 GPU,内存为 0,功率处于空闲状态。NVIDIA GPU 驱动程序版本(580.126.09)来自 Bottlerocket AMI,而 CUDA 版本(13.0)来自容器映像。GPU 型号和内存将因 Karpenter 选择的实例类型而异。G5 实例搭载 NVIDIA A10G GPU(24 GB),G6e 实例搭载 NVIDIA L40S GPU(48 GB),G7e 实例搭载 NVIDIA RTX PRO 6000 GPU(96 GB)。
要了解 Karpenter 和 Kubernetes 调度器如何协调工作来预调配节点和置放容器组,请查看容器组的生命周期事件:
```
kubectl describe po nvidia-smi
```
预期输出:
```
Events:
Type Reason Age From Message
---- ------ ---- ---- -------
Warning FailedScheduling 60s default-scheduler 0/2 nodes are available: 2 node(s) had untolerated taint(s). no new claims to deallocate, preemption: 0/2 nodes are available: 2 Preemption is not helpful for scheduling.
Normal Nominated 59s eks-auto-mode/compute Pod should schedule on: nodeclaim/gpu-inf-vxcnj
Normal Scheduled 24s default-scheduler Successfully assigned default/nvidia-smi to i-0fb17a09bc4203164
Warning FailedCreatePodSandBox 21s kubelet Failed to create pod sandbox: rpc error: code = Unknown desc = failed to setup network for sandbox "7f85e25b220c8fb245187758dbbbc8efb3d40f3e49e13054404880daf4c3b2f0": plugin type="aws-cni" name="aws-cni" failed (add): add cmd: failed to setup network policy
Normal Pulling 7s kubelet spec.containers{nvidia-smi}: Pulling image "public.ecr.aws/amazonlinux/amazonlinux:2023-minimal"
Normal Pulled 5s kubelet spec.containers{nvidia-smi}: Successfully pulled image "public.ecr.aws/amazonlinux/amazonlinux:2023-minimal" in 1.237s (1.237s including waiting). Image size: 37442701 bytes.
Normal Created 5s kubelet spec.containers{nvidia-smi}: Container created
Normal Started 5s kubelet spec.containers{nvidia-smi}: Container started
```
这些事件会显示容器组的调度顺序:容器组最初因 GPU 节点不存在而调度失败(FailedScheduling),然后 Karpenter 提名一个新的 NodeClaim(Nominated),然后调度器在节点准备就绪后分配容器组(Scheduled),最后拉取并启动容器映像。EKS 自动模式已在 G、P 和 Trn 实例上预先安装并配置了 SOCI(Seekable OCI)并行拉取。请注意,由于 SOCI 并行拉取的原因,从 ECR 中拉取容器映像的时间不到 2 秒(1.237 秒)。
NodeClaim 是 Karpenter 为预调配特定节点而创建的请求。该请求会显示实例类型、容量类型、可用区以及该节点是否准备就绪。
```
kubectl get nodeclaims
```
NodeClaim 的预期输出:
```
NAME TYPE CAPACITY ZONE NODE READY AGE
gpu-inf-xxxxx g7e.2xlarge spot us-east-2a i-0xxxxxxxxxxxx True 2m
```
实例类型和可用区会有差异。任何 4 代以上的 G 系列实例均符合要求。
`kubectl describe pod nvidia-smi` 中的 `FailedCreatePodSandBox` 警告是暂时性的,也符合预期。在节点加入后,VPC CNI 会异步初始化,kubelet 也会自动重试。如果容器组留在 `ContainerCreating` 中,请使用 `kubectl describe node ` 检查节点事件。
**提示**
如果未显示任何节点,请检查是否存在容量不足错误:
```
kubectl get events | grep InsufficientCapacityError
```
Karpenter 会将不可用实例缓存 3 分钟。扩大节点池中允许的实例类型和可用区可以提升获得容量的几率。
**注意**
Karpenter 启动的竞价型实例不会在 EC2 竞价型请求控制台中显示。Karpenter 将 EC2 [`CreateFleet`](https://docs.amazonaws.cn/AWSEC2/latest/APIReference/API_CreateFleet.html) API 与 `type: instant` 结合使用。这些实例会以 `spot` 生命周期在 EC2 实例控制台中显示。
## 第 4 步:将预留容量添加到节点池(可选)
要首先使用预留容量,然后再回退到竞价型/按需型容量,请创建一个 ODCR 并将其附加到您的节点类,然后更新第 2 步中的动态节点池以同时允许 `reserved` 容量。这两条路径的预留 API 调用相同;但节点类附件不同,因为 EKS 自动模式和自行管理的 Karpenter 使用不同种类的节点类。
**警告**
以下命令会产生预留实例类型费用,直到您使用 `aws ec2 cancel-capacity-reservation --capacity-reservation-id ` 将其取消为止。
创建容量预留:
```
CR_AZ="us-east-2a"
INSTANCE_TYPE="g6e.4xlarge"
aws ec2 create-capacity-reservation \
--instance-type $INSTANCE_TYPE \
--instance-platform Linux/UNIX \
--availability-zone "$CR_AZ" \
--instance-count 1 \
--instance-match-criteria open \
--end-date-type unlimited
```
如果出现 `InsufficientInstanceCapacity` 错误,请将 `CR_AZ` 更改为其他可用区并重试。
查找容量预留 ID 并将其存储在 Shell 变量中,以用于以下步骤:
```
CAPACITY_RESERVATION_ID=$(aws ec2 describe-capacity-reservations \
--filters "Name=state,Values=active" "Name=instance-type,Values=${INSTANCE_TYPE}" \
--query 'CapacityReservations[0].CapacityReservationId' \
--output text \
--region ${AWS_REGION})
echo "Capacity reservation ID: ${CAPACITY_RESERVATION_ID}"
```
然后根据您的路径应用节点类和节点池更改:
------
#### [ EKS Auto Mode ]
在 EKS 自动模式中,捆绑的 `default` 节点类是只读的,因此需要创建一个引用该预留的自定义节点类,然后更新节点池以指向该节点类,并将 `reserved` 容量添加到 `capacity-type` 列表中。
### 自定义节点类 YAML
```
NODE_ROLE=$(kubectl get nodeclass default -o jsonpath='{.spec.role}')
cat << EOF | kubectl apply -f -
apiVersion: eks.amazonaws.com/v1
kind: NodeClass
metadata:
name: gpu-inf
labels:
guide: ai-eks-docs
spec:
role: "$NODE_ROLE"
subnetSelectorTerms:
- tags:
alpha.eksctl.io/cluster-name: "$CLUSTER_NAME"
kubernetes.io/role/internal-elb: "1"
securityGroupSelectorTerms:
- tags:
aws:eks:cluster-name: "$CLUSTER_NAME"
capacityReservationSelectorTerms:
- id: "$CAPACITY_RESERVATION_ID"
EOF
```
`kubernetes.io/role/internal-elb: "1"` 标签用于确保节点仅在私有子网中启动。
更新节点池以使用 ODCR 支持的节点类,并将 `reserved` 作为容量类型包含在内:
### 更新后的节点池 YAML
```
cat << EOF | kubectl apply -f -
apiVersion: karpenter.sh/v1
kind: NodePool
metadata:
name: gpu-inf
spec:
template:
metadata:
labels:
guide: ai-eks-docs
spec:
nodeClassRef:
group: eks.amazonaws.com
kind: NodeClass
name: gpu-inf
taints:
- key: nvidia.com/gpu
effect: NoSchedule
requirements:
- key: karpenter.sh/capacity-type
operator: In
values: ["spot", "on-demand", "reserved"]
- key: eks.amazonaws.com/instance-category
operator: In
values: ["g"]
- key: eks.amazonaws.com/instance-generation
operator: Gt
values: ["4"]
- key: kubernetes.io/arch
operator: In
values: ["amd64"]
limits:
cpu: 1000
memory: 5000Gi
EOF
```
------
#### [ Self-managed Karpenter ]
对于自行管理的 Karpenter,请在添加 `capacityReservationSelectorTerms` 后重新应用您在第 2 步中创建的 `EC2NodeClass`。字段名称和形状与另一个选项卡中显示的 EKS 自动模式 `NodeClass` 一致。
### 更新后的 EC2NodeClass YAML
```
cat << EOF | kubectl apply -f -
apiVersion: karpenter.k8s.aws/v1
kind: EC2NodeClass
metadata:
name: gpu-inf
labels:
guide: ai-eks-docs
spec:
role: "eksctl-KarpenterNodeRole-${CLUSTER_NAME}"
amiSelectorTerms:
- alias: al2023@latest
subnetSelectorTerms:
- tags:
karpenter.sh/discovery: ${CLUSTER_NAME}
securityGroupSelectorTerms:
- tags:
karpenter.sh/discovery: ${CLUSTER_NAME}
tags:
karpenter.sh/discovery: ${CLUSTER_NAME}
instanceStorePolicy: RAID0
capacityReservationSelectorTerms:
- id: "$CAPACITY_RESERVATION_ID"
userData: |
MIME-Version: 1.0
Content-Type: multipart/mixed; boundary="BOUNDARY"
--BOUNDARY
Content-Type: application/node.eks.aws
---
apiVersion: node.eks.aws/v1alpha1
kind: NodeConfig
spec:
featureGates:
FastImagePull: true
containerd:
config: |
[plugins."io.containerd.snapshotter.v1.soci"]
[plugins."io.containerd.snapshotter.v1.soci".blob]
max_concurrent_downloads_per_image = 20
concurrent_download_chunk_size = "16mb"
max_concurrent_unpacks_per_image = 12
discard_unpacked_layers = true
--BOUNDARY--
EOF
```
与第 2 步相比的唯一更改是新增的 `capacityReservationSelectorTerms` 字段。所有其他字段均保持不变。
更新节点池以将 `reserved` 作为容量类型包括在内:
### 更新后的节点池 YAML
```
cat << EOF | kubectl apply -f -
apiVersion: karpenter.sh/v1
kind: NodePool
metadata:
name: gpu-inf
spec:
template:
metadata:
labels:
guide: ai-eks-docs
amiFamily: al2023
spec:
nodeClassRef:
group: karpenter.k8s.aws
kind: EC2NodeClass
name: gpu-inf
taints:
- key: nvidia.com/gpu
effect: NoSchedule
requirements:
- key: karpenter.sh/capacity-type
operator: In
values: ["spot", "on-demand", "reserved"]
- key: karpenter.k8s.aws/instance-category
operator: In
values: ["g"]
- key: karpenter.k8s.aws/instance-generation
operator: Gt
values: ["4"]
- key: kubernetes.io/arch
operator: In
values: ["amd64"]
limits:
cpu: 1000
memory: 5000Gi
EOF
```
------
Karpenter 将 `reserved` 视为最具成本效益的选项,因此会首先启动该容量。预留容量用完后,将会回退到竞价型或按需型容量。
### 验证是否会优先使用预留容量并回退到竞价型容量
应用更改后,验证 Karpenter 是否会优先使用预留容量并回退到竞价型或按需型容量。部署一个将为每个容器组请求 1 个 GPU 的双副本部署。ODCR 用于 1 个实例,因此第一个容器组会触发 Karpenter 启动预留节点。预留节点无法容纳第二个容器组,会触发 Karpenter 利用竞价型或按需型容量启动另一个节点。
```
cat << 'EOF' | kubectl apply -f -
apiVersion: apps/v1
kind: Deployment
metadata:
name: gpu-overflow-test
labels:
guide: ai-eks-docs
spec:
replicas: 2
selector:
matchLabels:
app: gpu-overflow-test
template:
metadata:
labels:
app: gpu-overflow-test
guide: ai-eks-docs
spec:
tolerations:
- key: nvidia.com/gpu
operator: Exists
effect: NoSchedule
containers:
- name: nvidia-smi
image: public.ecr.aws/amazonlinux/amazonlinux:2023-minimal
command: ["sh", "-c", "nvidia-smi && sleep infinity"]
resources:
limits:
nvidia.com/gpu: 1
EOF
```
与第 3 步中运行并退出的 `nvidia-smi` 测试容器组不同,此部署会保持容器组运行 (`sleep infinity`),因此会保持 GPU 且不释放节点。
验证在不同节点上调度的容器组:
```
kubectl get pods -l app=gpu-overflow-test -o wide
```
预期输出:
```
NAME READY STATUS RESTARTS AGE IP NODE NOMINATED NODE READINESS GATES
gpu-overflow-test-59b97944fb-lq56c 1/1 Running 0 2m42s 192.168.186.240 i-057692590480155da
gpu-overflow-test-59b97944fb-z4zcx 1/1 Running 0 2m42s 192.168.130.64 i-0521ecd1849fa0578
```
这两个容器组会分别在不同的节点上保持运行。
查看节点声明以查看容量类型:
```
kubectl get nodeclaims
```
预期输出:
```
NAME TYPE CAPACITY ZONE NODE READY AGE
gpu-inf-shg5w g6e.xlarge reserved us-east-2a i-0ea91fdeef65b8cb6 True 2m2s
gpu-inf-ssnqf g7e.2xlarge spot us-east-2b i-00ccf7ce65cf3f6ca True 112s
```
会首先启动预留节点,然后在预留容量用完后启动竞价型或按需型节点。
清理测试部署:
```
kubectl delete deployment gpu-overflow-test
```
## 监控
将用于收集集群、节点和 GPU 指标的监控堆栈安装到 Amazon Managed Service for Prometheus(AMP)中,然后使用 Grafana 将其可视化。kube-prometheus-stack Helm 图表会部署 Prometheus 来抓取指标并将其远程写入 AMP,此外还将部署一个自行管理的 Grafana 来用于控制面板。NVIDIA DCGM Exporter 会添加 GPU 特定的指标(利用率、内存、温度、功耗、NVLink、张量活动)。
默认情况下,Prometheus、Grafana 和运算符会着陆于非 GPU 节点,因为 GPU 节点带有 `nvidia.com/gpu:NoSchedule` 污点。节点导出器和 DCGM Exporter 都在 GPU 节点上运行,因此我们可以抓取整个实例集的主机和 GPU 指标。
如果您打开了新终端,请设置集群名称和区域:
```
export CLUSTER_NAME=ai-eks-docs
export AWS_REGION=us-east-2
```
### 创建 AMP 工作区
创建一个 AMP 工作空间以存储指标:
```
aws amp create-workspace \
--alias "amp-ws-${CLUSTER_NAME}" \
--region ${AWS_REGION}
```
获取工作区 ID:
```
AMP_WORKSPACE_ID=$(aws amp list-workspaces \
--alias "amp-ws-${CLUSTER_NAME}" \
--query 'workspaces[0].workspaceId' \
--output text \
--region ${AWS_REGION})
echo "AMP Workspace ID: ${AMP_WORKSPACE_ID}"
```
获取远程写入端点:
```
AMP_ENDPOINT=$(aws amp describe-workspace \
--workspace-id ${AMP_WORKSPACE_ID} \
--query 'workspace.prometheusEndpoint' \
--output text \
--region ${AWS_REGION})
echo "AMP Endpoint: ${AMP_ENDPOINT}"
```
### 创建 IAM 策略和 EKS 容器组身份关联
创建一个 IAM 策略,以允许 Prometheus 远程写入指标并允许 Grafana 查询这些指标:
```
ACCOUNT_ID=$(aws sts get-caller-identity --query Account --output text)
AMP_POLICY_ARN=$(aws iam create-policy \
--policy-name "${CLUSTER_NAME}-amp-grafana-policy" \
--policy-document "{\"Version\": \"2012-10-17\", \"Statement\": [{\"Sid\": \"AllowAMPReadWrite\", \"Effect\": \"Allow\", \"Action\": [\"aps:ListWorkspaces\", \"aps:DescribeWorkspace\", \"aps:GetMetricMetadata\", \"aps:GetSeries\", \"aps:QueryMetrics\", \"aps:RemoteWrite\", \"aps:GetLabels\"], \"Resource\": \"arn:aws:aps:${AWS_REGION}:${ACCOUNT_ID}:workspace/*\"}, {\"Sid\": \"AllowCloudWatchMetrics\", \"Effect\": \"Allow\", \"Action\": [\"cloudwatch:DescribeAlarmsForMetric\", \"cloudwatch:ListMetrics\", \"cloudwatch:GetMetricData\", \"cloudwatch:GetMetricStatistics\"], \"Resource\": \"*\"}]}" \
--query 'Policy.Arn' \
--output text)
echo "AMP Policy ARN: ${AMP_POLICY_ARN}"
```
为 Prometheus 和 Grafana 创建监控命名空间和服务账户:
```
kubectl create namespace monitoring
kubectl create serviceaccount amp-iamproxy-ingest-service-account -n monitoring
kubectl create serviceaccount grafana-sa -n monitoring
```
创建 EKS 容器组身份关联以将服务账户关联到 IAM 策略:
```
eksctl create podidentityassociation \
--cluster ${CLUSTER_NAME} \
--namespace monitoring \
--service-account-name amp-iamproxy-ingest-service-account \
--role-name "${CLUSTER_NAME}-amp-ingest-role" \
--permission-policy-arns ${AMP_POLICY_ARN} \
--region ${AWS_REGION}
eksctl create podidentityassociation \
--cluster ${CLUSTER_NAME} \
--namespace monitoring \
--service-account-name grafana-sa \
--role-name "${CLUSTER_NAME}-grafana-role" \
--permission-policy-arns ${AMP_POLICY_ARN} \
--region ${AWS_REGION}
```
验证这两个 EKS 容器组身份关联是否均已创建:
```
eksctl get podidentityassociation --cluster ${CLUSTER_NAME} --region ${AWS_REGION}
```
预期输出应在 `monitoring` 命名空间中同时包含 `amp-iamproxy-ingest-service-account` 和 `grafana-sa`。
### 安装 kube-prometheus-stack
添加 Helm 存储库:
```
helm repo add prometheus-community https://prometheus-community.github.io/helm-charts
helm repo update
```
该值文件省略了 Prometheus、Grafana 和运算符的 nodeSelector:GPU 节点的 `nvidia.com/gpu:NoSchedule` 污点导致它们不能着陆于 GPU 节点,因此默认情况下会着陆于系统或通用池中。节点导出器使用通配符容差,因此可以在每个节点(包括 GPU 节点)上运行,以收集整个实例集的指标。
创建值文件:
#### kube-prometheus-stack 值文件
```
cat << EOF > /tmp/kube-prometheus-values.yaml
prometheus:
serviceAccount:
create: false
name: amp-iamproxy-ingest-service-account
prometheusSpec:
serviceAccountName: amp-iamproxy-ingest-service-account
remoteWrite:
- url: "${AMP_ENDPOINT}api/v1/remote_write"
sigv4:
region: "${AWS_REGION}"
queueConfig:
maxSamplesPerSend: 1000
maxShards: 200
capacity: 2500
retention: 5h
scrapeInterval: 30s
evaluationInterval: 30s
podMonitorSelectorNilUsesHelmValues: false
serviceMonitorSelectorNilUsesHelmValues: false
alertmanager:
enabled: false
grafana:
enabled: true
serviceAccount:
create: false
name: grafana-sa
grafana.ini:
auth.sigv4:
enabled: true
sidecar:
datasources:
defaultDatasourceEnabled: false
plugins:
- grafana-amazonprometheus-datasource
additionalDataSources:
- name: Amazon-Managed-Prometheus
type: grafana-amazonprometheus-datasource
access: proxy
url: "${AMP_ENDPOINT}"
isDefault: true
jsonData:
sigV4Auth: true
defaultRegion: "${AWS_REGION}"
sigV4Region: "${AWS_REGION}"
editable: true
dashboardProviders:
dashboardproviders.yaml:
apiVersion: 1
providers:
- name: default
orgId: 1
folder: 'GPU Monitoring'
type: file
disableDeletion: false
editable: true
options:
path: /var/lib/grafana/dashboards/default
dashboards:
default:
nvidia-dcgm:
gnetId: 25261
revision: 1
datasource:
- name: DS_PROMETHEUS
value: Amazon-Managed-Prometheus
vllm:
gnetId: 25263
revision: 1
datasource:
- name: DS_PROMETHEUS
value: Amazon-Managed-Prometheus
prometheus-node-exporter:
tolerations:
- operator: Exists
EOF
```
验证变量是否已正确填充:
```
grep -E "url:|region:|tolerations:" /tmp/kube-prometheus-values.yaml
```
您应会看到完整的 AMP 端点 URL(以 `https://aps-workspaces…` 开头)、您所在的区域以及节点导出器 `tolerations:` 行。如果有任何为空,请重新导出变量并重新创建该文件。
安装图表:
```
helm install kube-prometheus-stack prometheus-community/kube-prometheus-stack \
--namespace monitoring \
-f /tmp/kube-prometheus-values.yaml
```
验证容器组是否正在运行:
```
kubectl get pods -n monitoring
```
预期输出:
```
NAME READY STATUS RESTARTS AGE
kube-prometheus-stack-grafana-7c58f54f77-rftrj 3/3 Running 0 4m
kube-prometheus-stack-kube-state-metrics-d68dcbc84-5smxq 1/1 Running 0 4m
kube-prometheus-stack-operator-5895df479f-ttm47 1/1 Running 0 4m
kube-prometheus-stack-prometheus-node-exporter-t9q7s 1/1 Running 0 4m
kube-prometheus-stack-prometheus-node-exporter-x6vfb 1/1 Running 0 4m
prometheus-kube-prometheus-stack-prometheus-0 2/2 Running 0 4m
```
该堆栈会部署以下组件:
+ **Prometheus**(StatefulSet):抓取指标并将其远程写入 AMP
+ **Grafana**:控制面板和可视化组件,已预先配置 AMP 数据来源
+ **kube-state-metrics**:生成有关 Kubernetes 对象状态的指标(容器组状态、资源请求量/限制、节点声明状态)
+ **节点导出器**(DaemonSet,每个节点一个):收集主机级别指标(CPU、内存、磁盘、网络)
+ **运算符**:管理 Prometheus 和 Alertmanager 自定义资源
Alertmanager 在此设置中处于已禁用状态。
### 访问 Grafana
打开一个单独的终端和端口转发来访问 Grafana:
```
kubectl port-forward svc/kube-prometheus-stack-grafana 3000:80 -n monitoring
```
在浏览器中打开 [http://localhost:3000](http://localhost:3000)。使用用户名 `admin` 和来自以下命令的密码登录:
```
kubectl --namespace monitoring get secrets kube-prometheus-stack-grafana -o jsonpath="{.data.admin-password}" | base64 -d ; echo
```
要验证指标管道是否端对端正常运行,请执行以下操作:
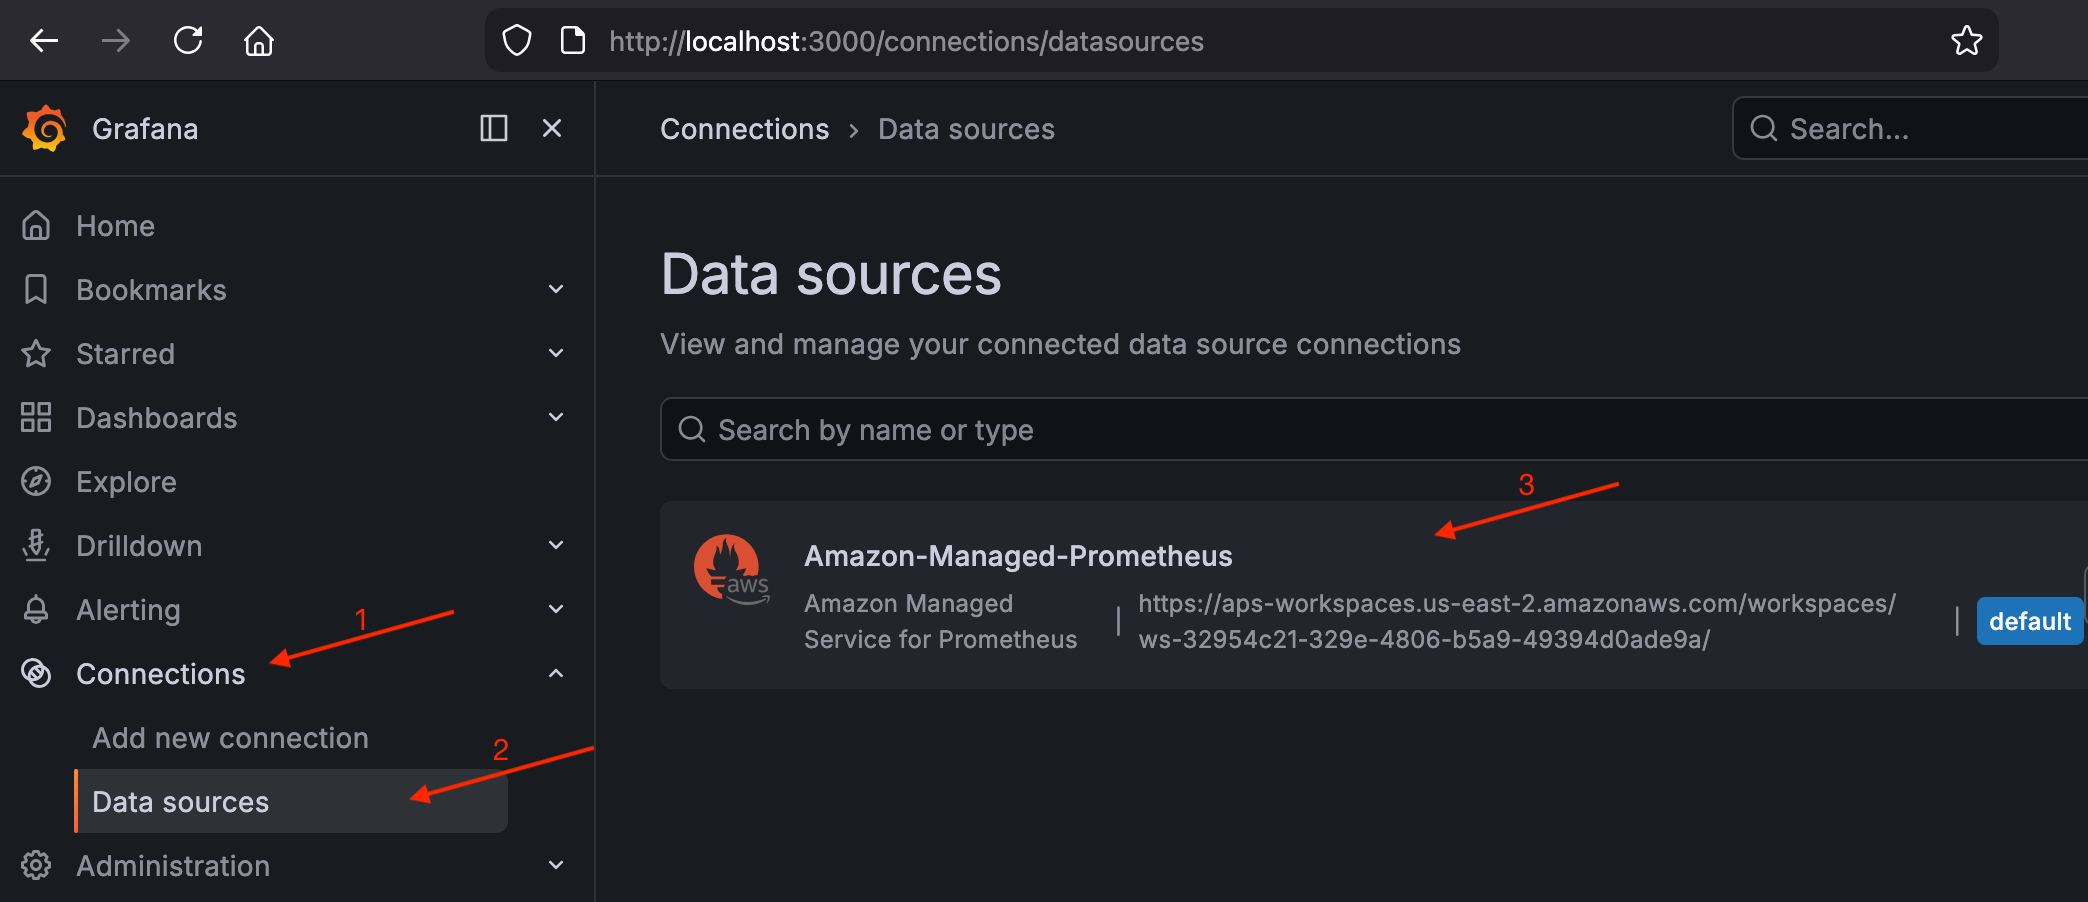
1. 导航至**连接 > 数据来源**,并确认已将 `Amazon-Managed-Prometheus` 作为默认数据来源列出。
**在 Grafana 中验证 AMP 数据来源**
1. 导航至 **Drilldown > 指标**,然后搜索 `up` 指标。您应会看到集群抓取目标的结果。
**在 Grafana 中验证 `up` 指标**
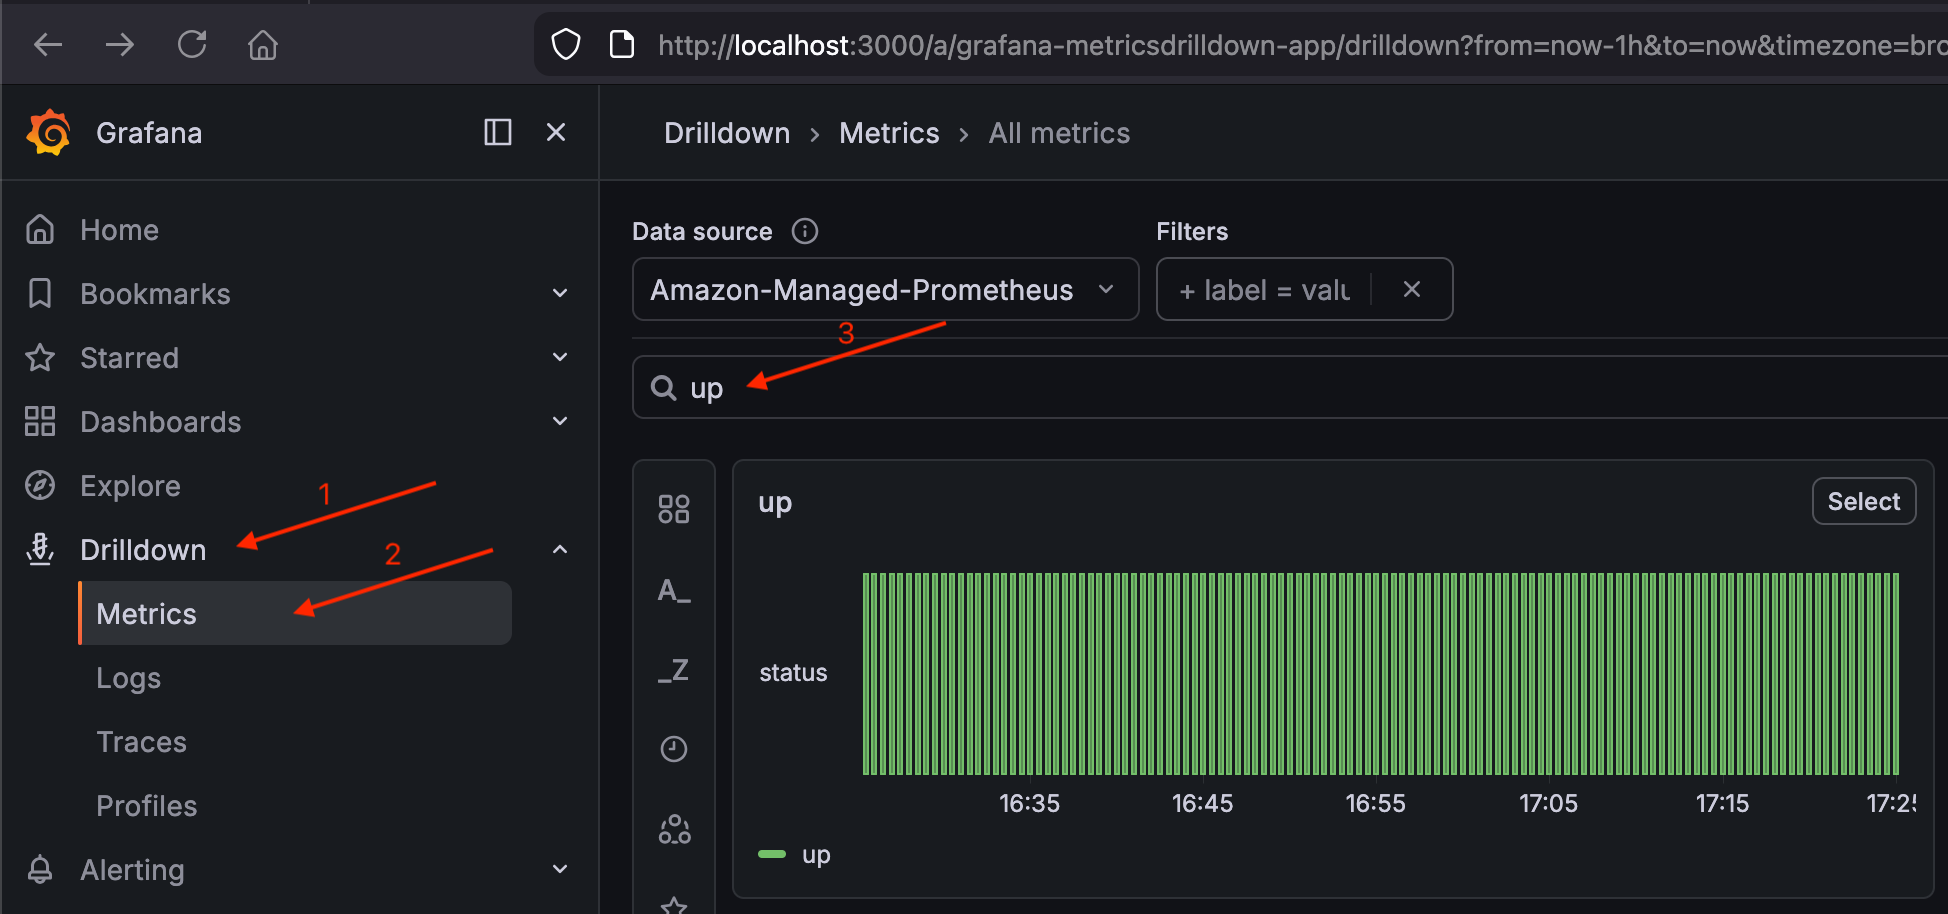
如果 `up` 显示结果,则说明管道(集群 → Prometheus → AMP → Grafana)在正常运行。
### 部署用于 GPU 指标的 DCGM Exporter
kube-prometheus-stack 会收集节点级别的 CPU 和内存指标,但不会收集 GPU 指标。NVIDIA DCGM Exporter 会添加 GPU 利用率、内存使用情况、温度、功耗、NVLink、张量活动等指标。
```
helm repo add gpu-helm-charts https://nvidia.github.io/dcgm-exporter/helm-charts
helm repo update
```
设置路径的 GPU 节点选择器键。EKS 自动模式和自行管理的 Karpenter 使用不同的标签键来指示 GPU 制造商。
------
#### [ EKS Auto Mode ]
```
GPU_NODE_SELECTOR_KEY="eks.amazonaws.com/instance-gpu-manufacturer"
```
------
#### [ Self-managed Karpenter ]
```
GPU_NODE_SELECTOR_KEY="karpenter.k8s.aws/instance-gpu-manufacturer"
```
------
创建 DCGM Exporter 值文件:
#### dcgm-exporter 值文件
```
cat << EOF > /tmp/dcgm-exporter-values.yaml
resources:
requests:
memory: "512Mi"
cpu: "100m"
limits:
memory: "1Gi"
cpu: "500m"
serviceMonitor:
enabled: true
additionalLabels:
release: kube-prometheus-stack
nodeSelector:
${GPU_NODE_SELECTOR_KEY}: nvidia
tolerations:
- key: "nvidia.com/gpu"
operator: "Exists"
effect: "NoSchedule"
customMetrics: |
# Clocks
DCGM_FI_DEV_SM_CLOCK, gauge, SM clock frequency (in MHz).
DCGM_FI_DEV_MEM_CLOCK, gauge, Memory clock frequency (in MHz).
# Temperature
DCGM_FI_DEV_MEMORY_TEMP, gauge, Memory temperature (in C).
DCGM_FI_DEV_GPU_TEMP, gauge, GPU temperature (in C).
# Power
DCGM_FI_DEV_POWER_USAGE, gauge, Power draw (in W).
DCGM_FI_DEV_TOTAL_ENERGY_CONSUMPTION, counter, Total energy consumption since boot (in mJ).
# PCIe
DCGM_FI_PROF_PCIE_TX_BYTES, counter, Number of bytes transmitted through PCIe TX (in KB) via NVML.
DCGM_FI_PROF_PCIE_RX_BYTES, counter, Number of bytes received through PCIe RX (in KB) via NVML.
DCGM_FI_DEV_PCIE_REPLAY_COUNTER, counter, Total number of PCIe retries.
# Utilization (the sample period varies depending on the product)
DCGM_FI_DEV_GPU_UTIL, gauge, GPU utilization (in %).
DCGM_FI_DEV_MEM_COPY_UTIL, gauge, Memory utilization (in %).
DCGM_FI_DEV_ENC_UTIL, gauge, Encoder utilization (in %).
DCGM_FI_DEV_DEC_UTIL, gauge, Decoder utilization (in %).
# Errors and violations
DCGM_FI_DEV_XID_ERRORS, gauge, Value of the last XID error encountered.
DCGM_EXP_XID_ERRORS_COUNT, gauge, Value of count of XID errors encountered.
DCGM_FI_DEV_POWER_VIOLATION, counter, Throttling duration due to power constraints (in us).
DCGM_FI_DEV_THERMAL_VIOLATION, counter, Throttling duration due to thermal constraints (in us).
DCGM_FI_DEV_SYNC_BOOST_VIOLATION, counter, Throttling duration due to sync-boost constraints (in us).
DCGM_FI_DEV_BOARD_LIMIT_VIOLATION, counter, Throttling duration due to board limit constraints (in us).
DCGM_FI_DEV_LOW_UTIL_VIOLATION, counter, Throttling duration due to low utilization (in us).
DCGM_FI_DEV_RELIABILITY_VIOLATION, counter, Throttling duration due to reliability constraints (in us).
# Memory usage
DCGM_FI_DEV_FB_FREE, gauge, Framebuffer memory free (in MiB).
DCGM_FI_DEV_FB_USED, gauge, Framebuffer memory used (in MiB).
# Retired pages
DCGM_FI_DEV_RETIRED_SBE, counter, Total number of retired pages due to single-bit errors.
DCGM_FI_DEV_RETIRED_DBE, counter, Total number of retired pages due to double-bit errors.
DCGM_FI_DEV_RETIRED_PENDING, counter, Total number of pages pending retirement.
# NVLink
DCGM_FI_DEV_NVLINK_BANDWIDTH_TOTAL, counter, Total number of NVLink bandwidth counters for all lanes.
DCGM_FI_PROF_NVLINK_TX_BYTES, counter, The rate of data transmitted over NVLink not including protocol headers in bytes per second.
DCGM_FI_PROF_NVLINK_RX_BYTES, counter, The rate of data received over NVLink not including protocol headers in bytes per second.
# DCP metrics
DCGM_FI_PROF_GR_ENGINE_ACTIVE, gauge, Ratio of time the graphics engine is active (in %).
DCGM_FI_PROF_SM_ACTIVE, gauge, The ratio of cycles an SM has at least 1 warp assigned (in %).
DCGM_FI_PROF_SM_OCCUPANCY, gauge, The ratio of number of warps resident on an SM (in %).
DCGM_FI_PROF_PIPE_TENSOR_ACTIVE, gauge, Ratio of cycles the tensor (HMMA) pipe is active (in %).
DCGM_FI_PROF_DRAM_ACTIVE, gauge, Ratio of cycles the device memory interface is active sending or receiving data (in %).
DCGM_FI_DEV_CLOCK_THROTTLE_REASONS, gauge, Current clock throttle reasons (bitmask of DCGM_CLOCKS_THROTTLE_REASON_*).
DCGM_FI_DEV_GPU_NVLINK_ERRORS, gauge, Identifies a GPU NVLink error type returned by DCGM_FI_DEV_GPU_NVLINK_ERRORS.
## NVLink
DCGM_FI_DEV_NVLINK_BANDWIDTH_L0, counter, The number of bytes of active NVLink rx or tx data including both header and payload.
## Remapped rows
DCGM_FI_DEV_UNCORRECTABLE_REMAPPED_ROWS, counter, Number of remapped rows for uncorrectable errors.
DCGM_FI_DEV_CORRECTABLE_REMAPPED_ROWS, counter, Number of remapped rows for correctable errors.
DCGM_FI_DEV_ROW_REMAP_FAILURE, gauge, whether remapping of rows has failed.
## Profiling metrics
DCGM_FI_PROF_PIPE_FP64_ACTIVE, gauge, Ratio of cycles the fp64 pipes are active (in %).
DCGM_FI_PROF_PIPE_FP32_ACTIVE, gauge, Ratio of cycles the fp32 pipes are active (in %).
DCGM_FI_PROF_PIPE_FP16_ACTIVE, gauge, Ratio of cycles the fp16 pipes are active (in %).
# ECC
DCGM_FI_DEV_ECC_SBE_VOL_TOTAL, counter, Total number of single-bit volatile ECC errors.
DCGM_FI_DEV_ECC_DBE_VOL_TOTAL, counter, Total number of double-bit volatile ECC errors.
EOF
```
`customMetrics` 字段使用扩展指标集覆盖 DCGM Exporter 的默认指标集,该扩展指标集包括 NVLink 带宽、张量活动、PCIe 吞吐量、ECC 误差和热节流等指标。对于推理工作负载,这有助于您了解 GPU 计算单元是否已完全利用,GPU 是否由于批处理大小过小而在请求之间处于空闲状态,CPU 和 GPU 之间的数据传输是否存在瓶颈,热节流是否会导致延迟峰值,以及还有多少 GPU 内存余量可用于大型批处理。
安装 DCGM Exporter:
```
helm install dcgm-exporter gpu-helm-charts/dcgm-exporter \
--namespace monitoring \
-f /tmp/dcgm-exporter-values.yaml
```
`tolerations` 允许导出器在您于第 2 步中预调配的 GPU 污点节点上运行。带有 `release: kube-prometheus-stack` 标签的 `serviceMonitor` 可确保 Prometheus 会自动发现并抓取它。
验证 DCGM Exporter DaemonSet:
```
kubectl get daemonset dcgm-exporter -n monitoring
```
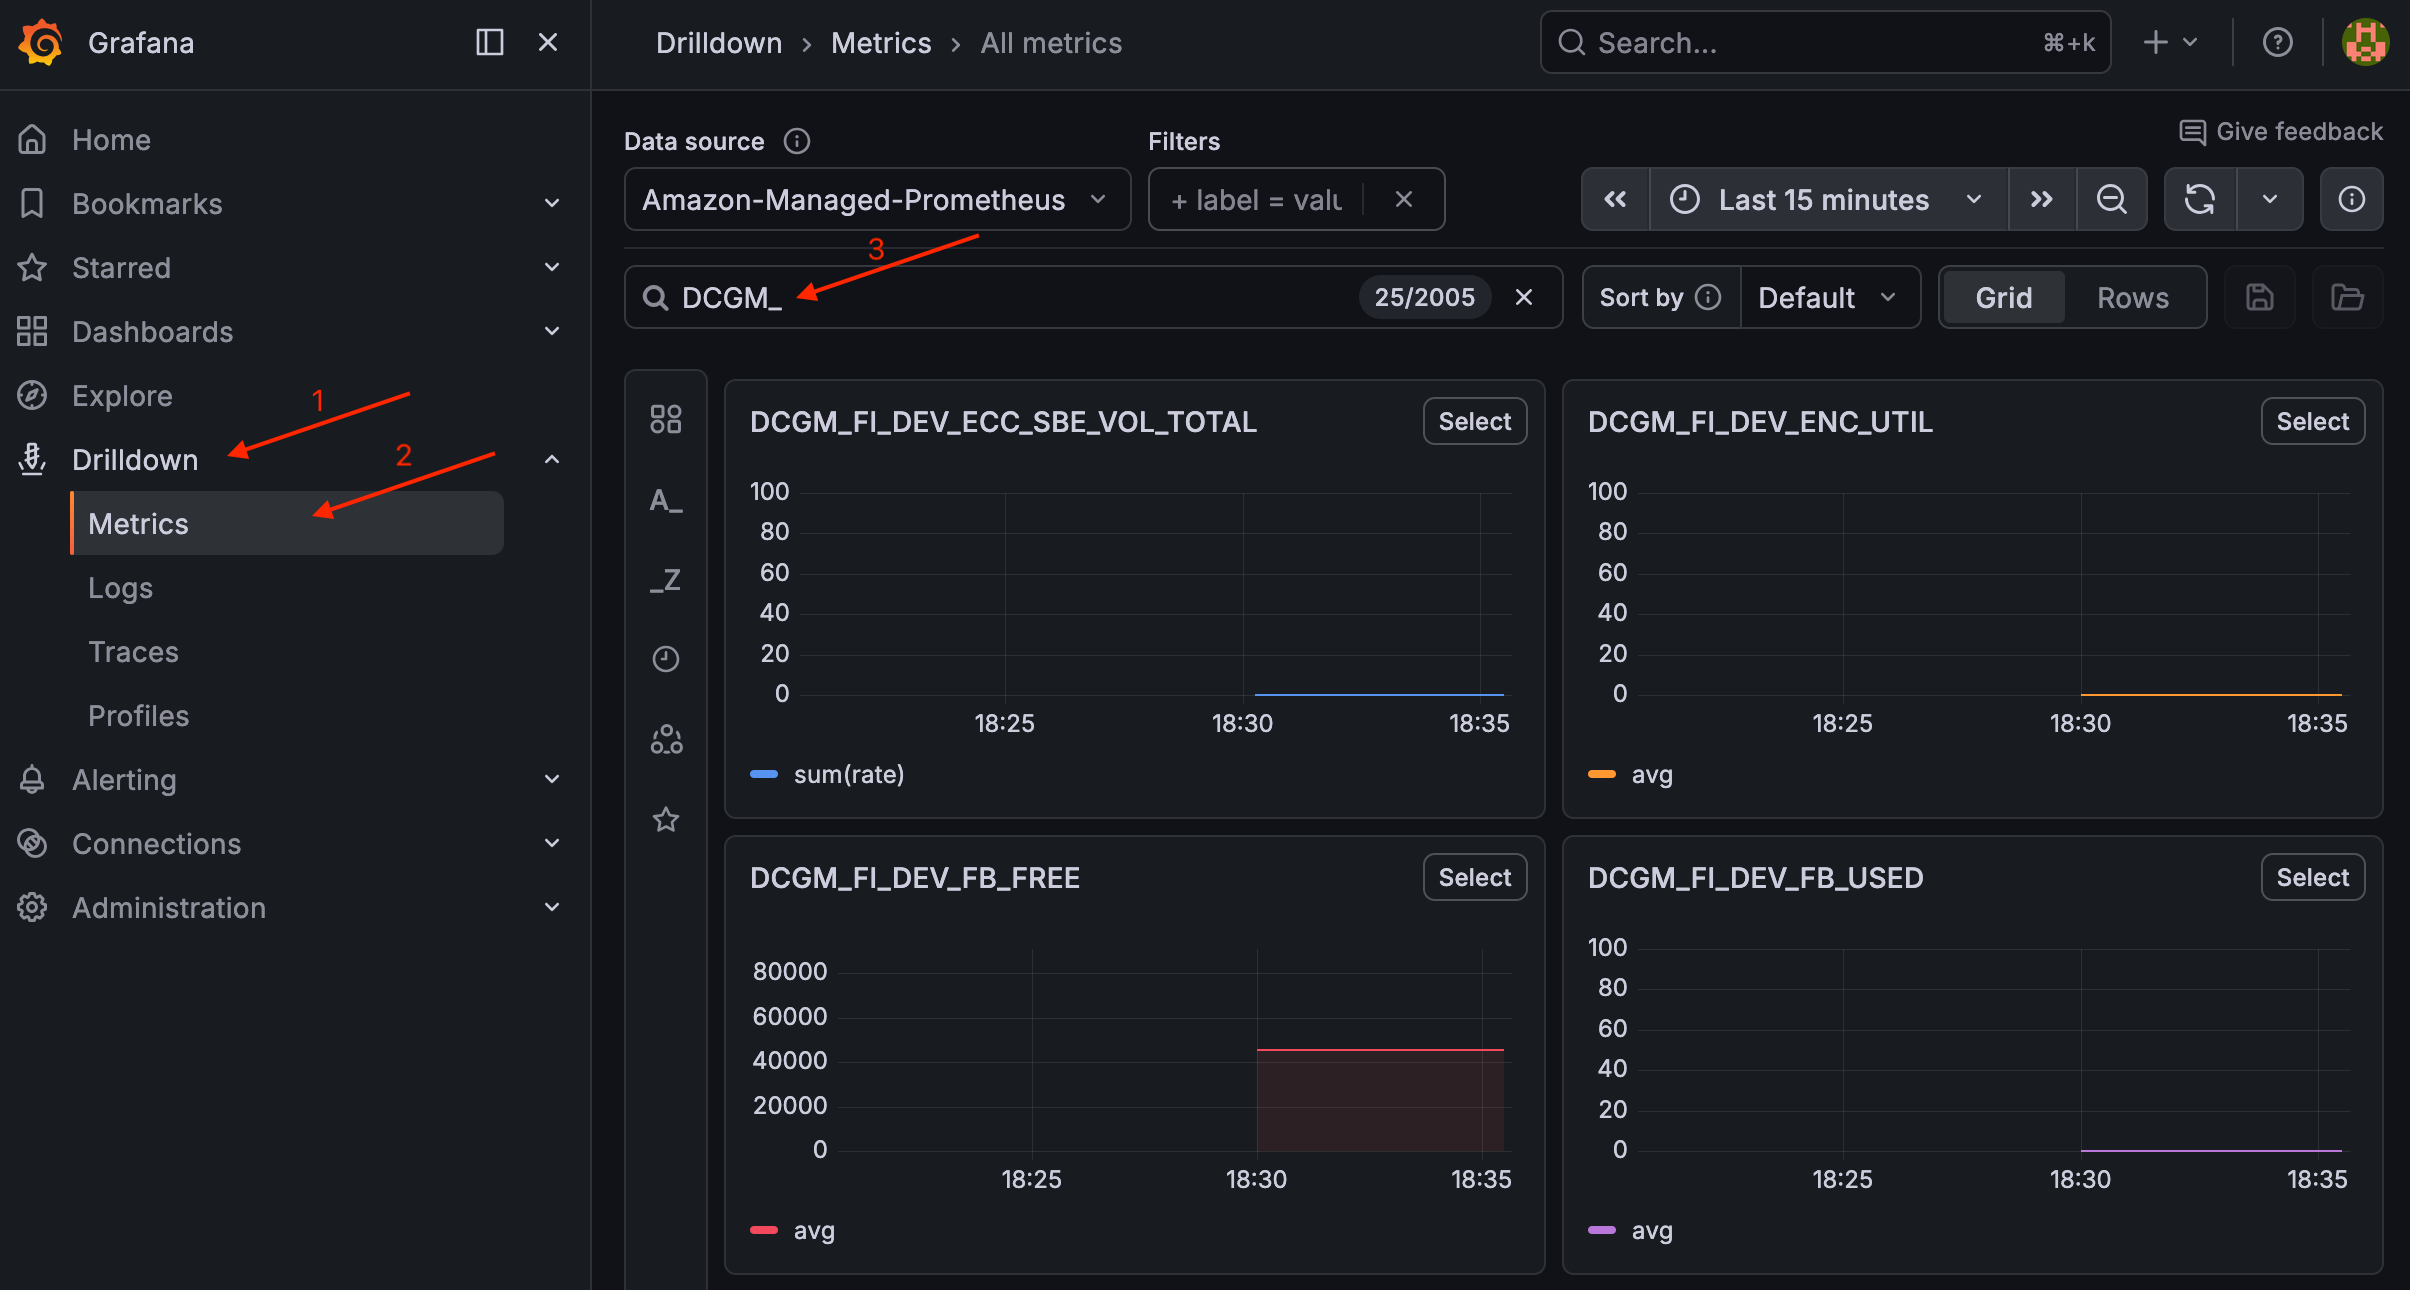
GPU 节点运行后,您应会看到一个处于就绪状态的容器组。要验证 DCGM 指标,请导航到 Grafana 中的 **Drilldown > 指标**并搜索 `DCGM_`。
**在 Grafana 中验证 DCGM 指标**
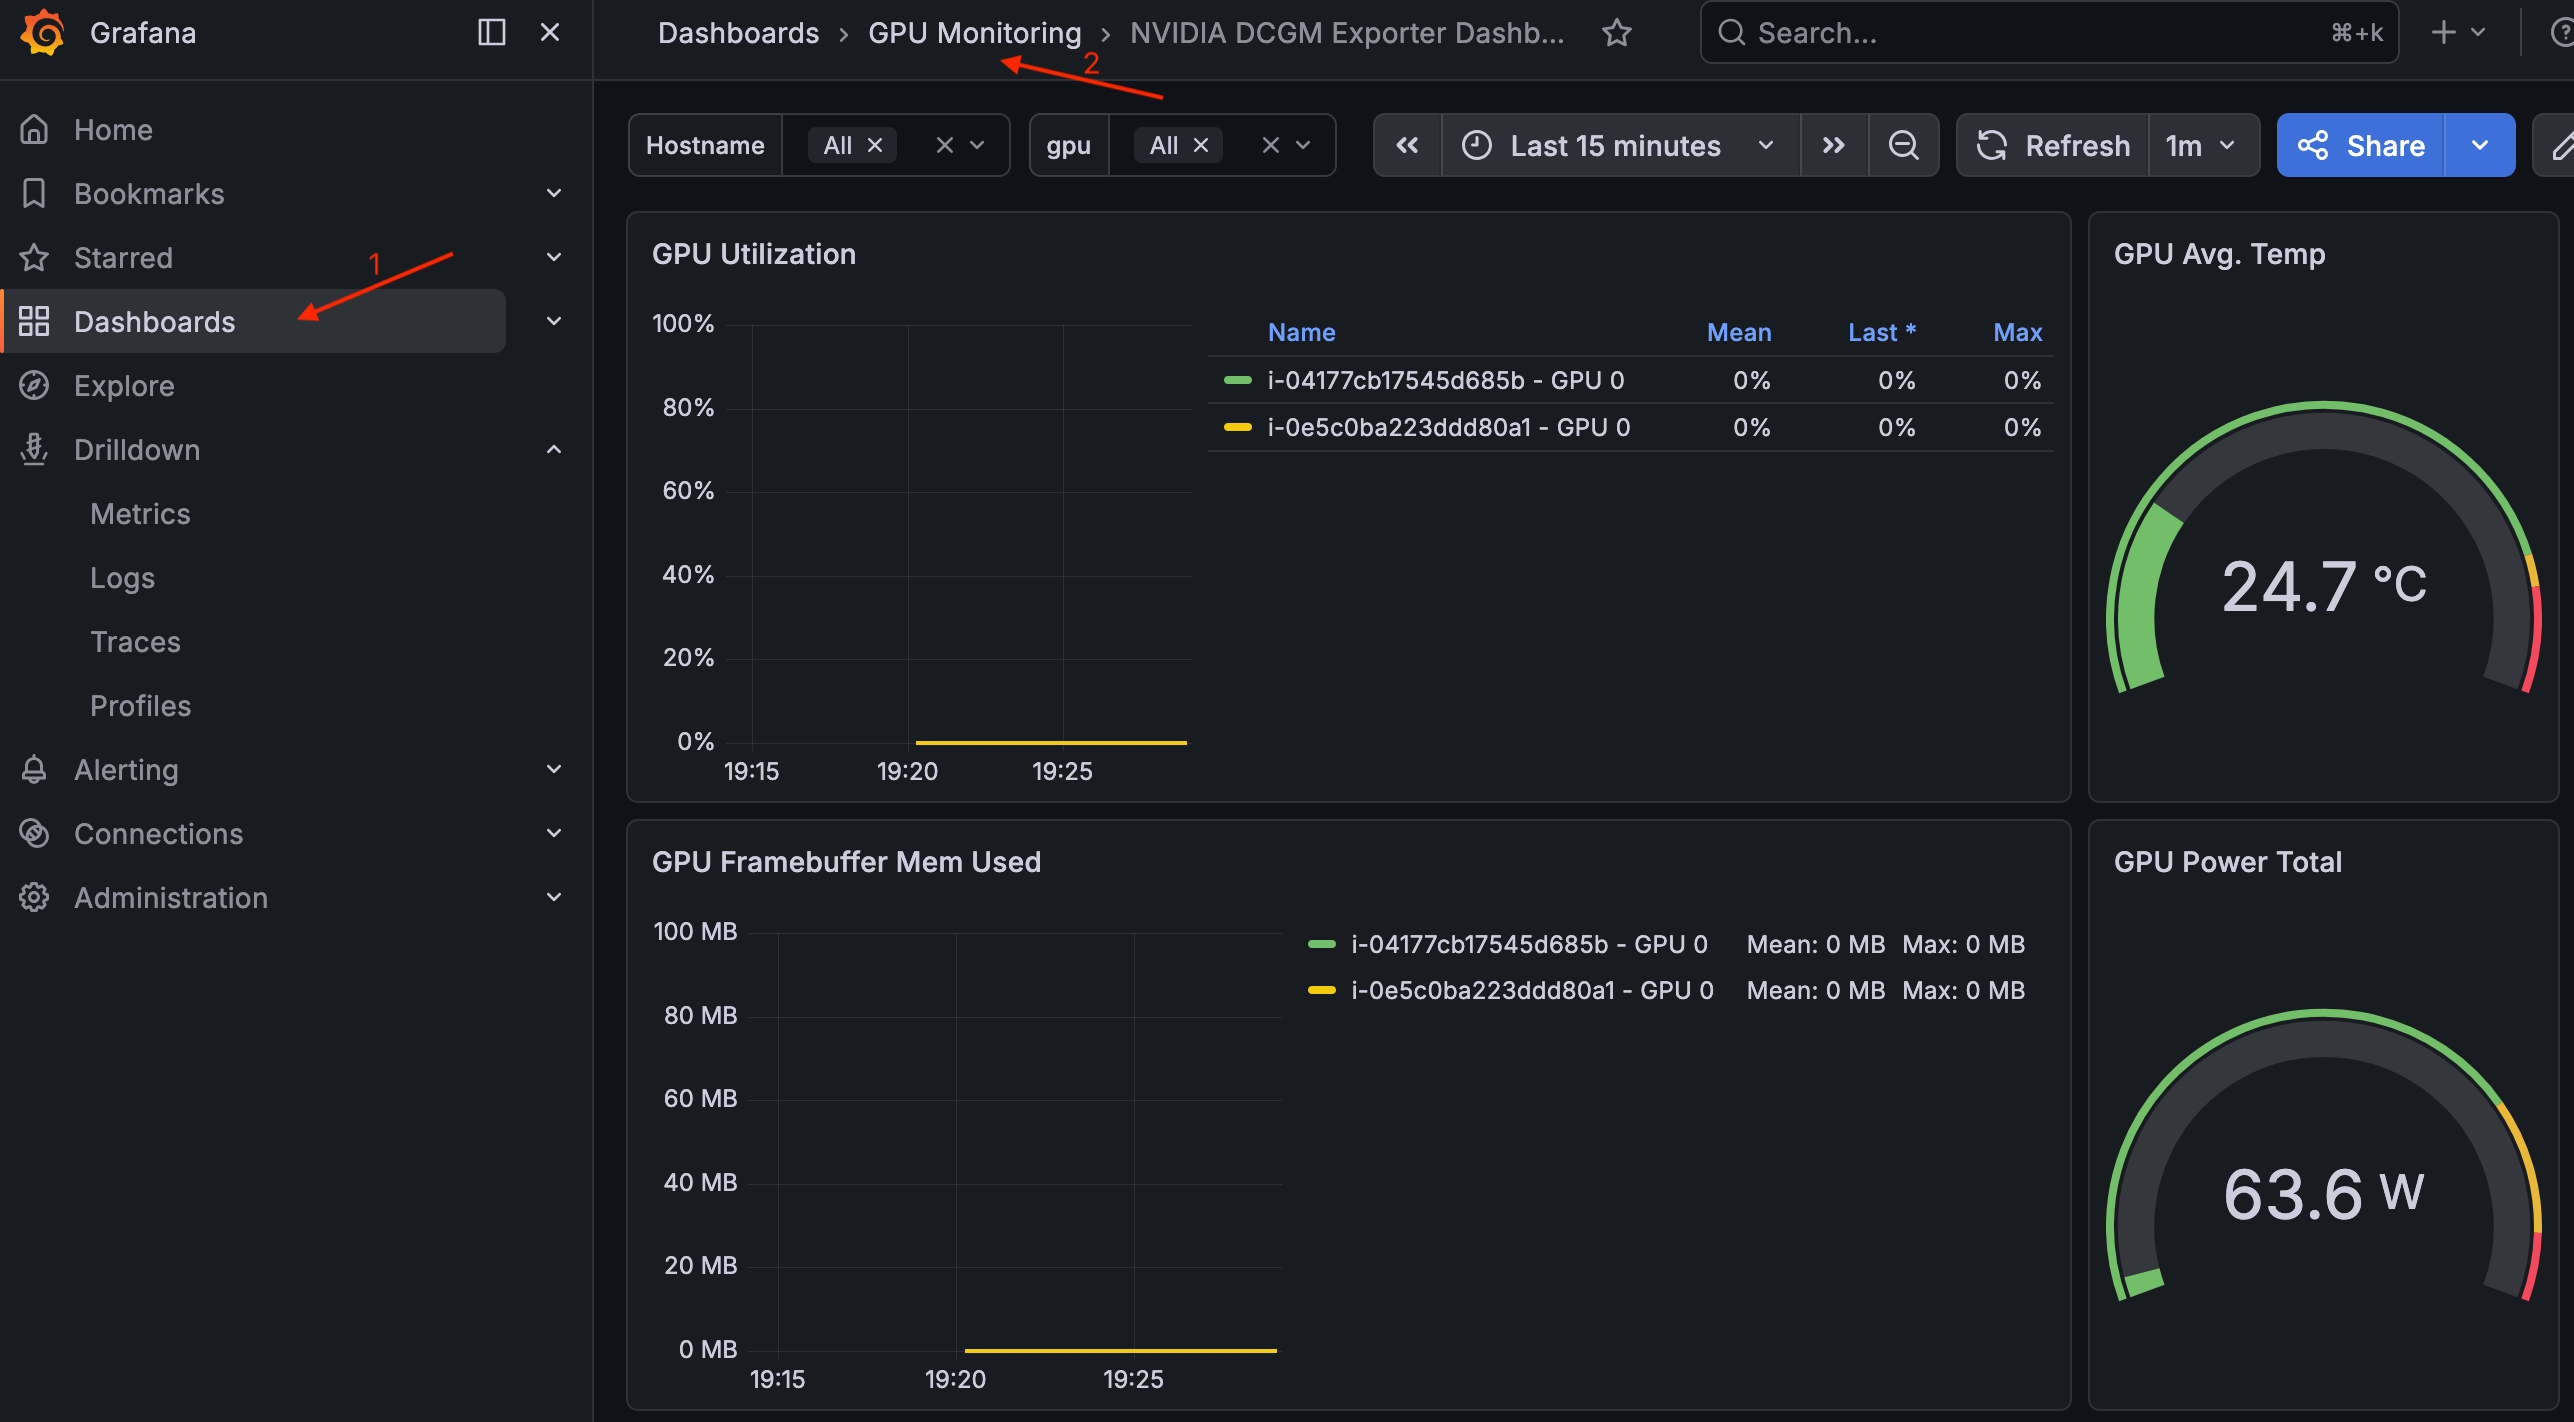
要查看控制面板,请导航至**控制面板 > GPU 监控 > NVIDIA DCGM Exporter 控制面板**。
**Grafana 中的 NVIDIA DCGM Exporter 控制面板**
## 模型权重 S3 存储桶
创建一个用于存储模型权重的 Amazon S3 存储桶,并配置 EKS 容器组身份关联,以便工作负载容器组可以对其进行读写。
如果您打开了新终端,请设置集群名称和区域:
```
export CLUSTER_NAME=ai-eks-docs
export AWS_REGION=us-east-2
```
### 创建 S3 存储桶
使用随机后缀创建存储桶以避免名称冲突:
```
BUCKET_SUFFIX=$(head -c 4 /dev/urandom | od -An -tx1 | tr -d ' \n')
MODEL_BUCKET="${CLUSTER_NAME}-models-${BUCKET_SUFFIX}"
aws s3 mb s3://${MODEL_BUCKET} --region ${AWS_REGION}
```
2023 年 1 月之后创建的 S3 存储桶会默认启用服务器端加密(AES256)和屏蔽公共访问权限功能。
### 配置 EKS 容器组身份以访问 S3
在 `default` 命名空间中创建一个 `model-storage-sa` 服务账户、一个限定于该模型存储桶的 IAM 策略以及一个将两者关联起来的 EKS容器组身份关联。设置 `serviceAccountName: model-storage-sa` 的工作负载容器组将能够在该存储桶中读写。
```
kubectl create serviceaccount model-storage-sa
```
创建 IAM 策略:
```
POLICY_ARN=$(aws iam create-policy \
--policy-name "${CLUSTER_NAME}-model-storage-policy" \
--policy-document "{\"Version\": \"2012-10-17\", \"Statement\": [{\"Effect\": \"Allow\", \"Action\": [\"s3:GetObject\", \"s3:PutObject\", \"s3:ListBucket\", \"s3:DeleteObject\"], \"Resource\": [\"arn:aws:s3:::${MODEL_BUCKET}\", \"arn:aws:s3:::${MODEL_BUCKET}/*\"]}]}" \
--query 'Policy.Arn' \
--output text)
echo "Policy ARN: ${POLICY_ARN}"
```
**注意**
此策略将授予验证步骤所需的 `s3:DeleteObject` 和 `s3:PutObject` 权限。对于仅读取模型权重的生产推理容器组,请移除 `s3:PutObject` 和 `s3:DeleteObject` 以遵循最低权限原则。
创建 EKS 容器组身份关联。`eksctl` 会创建具有正确信任策略的 IAM 角色并将其关联到该服务账户:
```
eksctl create podidentityassociation \
--cluster ${CLUSTER_NAME} \
--namespace default \
--service-account-name model-storage-sa \
--role-name "${CLUSTER_NAME}-model-storage-role" \
--permission-policy-arns ${POLICY_ARN} \
--region ${AWS_REGION}
```
验证关联:
```
eksctl get podidentityassociation --cluster ${CLUSTER_NAME} --region ${AWS_REGION}
```
输出的 `default` 命名空间中应包含 `model-storage-sa` 关联。
#### 验证从容器组访问 S3 的权限
使用 `model-storage-sa` 账户运行具有 Amazon CLI 映像的一次性容器组,以确认 EKS 容器组身份已上线并且能够正常访问 S3:
```
cat << EOF | kubectl apply -f -
apiVersion: v1
kind: Pod
metadata:
name: s3-test
labels:
guide: ai-eks-docs
spec:
serviceAccountName: model-storage-sa
containers:
- name: aws-cli
image: public.ecr.aws/aws-cli/aws-cli:2.27.0
command:
- sh
- -c
- |
echo "=== Caller Identity ==="
aws sts get-caller-identity
echo ""
echo "=== S3 Write Test ==="
echo "pod identity works" | aws s3 cp - s3://${MODEL_BUCKET}/test.txt
echo ""
echo "=== S3 List Test ==="
aws s3 ls s3://${MODEL_BUCKET}/
echo ""
echo "=== S3 Delete Test ==="
aws s3 rm s3://${MODEL_BUCKET}/test.txt
restartPolicy: Never
EOF
```
等待容器组完成并检查日志:
```
kubectl wait --for=jsonpath='{.status.phase}'=Succeeded pod/s3-test --timeout=300s
kubectl logs s3-test
```
预期输出:
```
=== Caller Identity ===
{
"UserId": "AROA...:eks-ai-eks-docs-model-s-...",
"Account": "123456789012",
"Arn": "arn:aws:sts::123456789012:assumed-role/ai-eks-docs-model-storage-role/eks-ai-eks-docs-model-s-..."
}
=== S3 Write Test ===
upload: - to s3://ai-eks-docs-models-01234567/test.txt
=== S3 List Test ===
2026-05-04 12:00:00 19 test.txt
=== S3 Delete Test ===
delete: s3://ai-eks-docs-models-01234567/test.txt
```
调用方身份通过 EKS 容器组身份确认该容器组已代入了 `${CLUSTER_NAME}-model-storage-role` 角色。S3 命令会确认读取和写入权限。
清理测试容器组:
```
kubectl delete pod s3-test
```
## 后续步骤
集群准备就绪后,您可以继续[加载和服务模型](ml-inference-load-serve-model.md),以部署大语言模型并与推理端点进行互动。
## 清理
**提示**
如果您计划继续完成本指南的后续章节,请跳过完整清理。请仅在操作完成后再运行完整清理。
```
export CLUSTER_NAME=ai-eks-docs
export AWS_REGION=us-east-2
```
```
kubectl delete pod nvidia-smi --ignore-not-found
kubectl delete deployment gpu-overflow-test --ignore-not-found
```
### 取消容量预留
如果您创建了 ODCR,请先将其取消:
```
INSTANCE_TYPE="g6e.4xlarge"
CAPACITY_RESERVATION_ID=$(aws ec2 describe-capacity-reservations \
--filters "Name=state,Values=active" "Name=instance-type,Values=${INSTANCE_TYPE}" \
--query 'CapacityReservations[0].CapacityReservationId' \
--output text \
--region ${AWS_REGION})
aws ec2 cancel-capacity-reservation --capacity-reservation-id ${CAPACITY_RESERVATION_ID}
```
**重要**
取消预留不会终止正在运行的实例。在终止之前,这些实例将继续按标准的按需费率收费。请首先删除部署以耗尽预留节点,然后再将其取消。
### 清理监控
查找 IAM 策略 ARN:
```
AMP_POLICY_ARN=$(aws iam list-policies \
--scope Local \
--query "Policies[?PolicyName=='${CLUSTER_NAME}-amp-grafana-policy'].Arn" \
--output text)
echo "AMP Policy ARN: ${AMP_POLICY_ARN}"
```
查找 AMP 工作区 ID:
```
AMP_WORKSPACE_ID=$(aws amp list-workspaces \
--alias "amp-ws-${CLUSTER_NAME}" \
--query 'workspaces[0].workspaceId' \
--output text \
--region ${AWS_REGION})
echo "AMP Workspace ID: ${AMP_WORKSPACE_ID}"
```
卸载 DCGM Exporter Helm 发行版:
```
helm uninstall dcgm-exporter -n monitoring
```
卸载 kube-prometheus-stack Helm 发行版:
```
helm uninstall kube-prometheus-stack -n monitoring
```
删除 Prometheus 摄取服务账户的 EKS 容器组身份关联:
```
eksctl delete podidentityassociation \
--cluster ${CLUSTER_NAME} \
--namespace monitoring \
--service-account-name amp-iamproxy-ingest-service-account \
--region ${AWS_REGION}
```
删除 Grafana 服务账户的 EKS 容器组身份关联:
```
eksctl delete podidentityassociation \
--cluster ${CLUSTER_NAME} \
--namespace monitoring \
--service-account-name grafana-sa \
--region ${AWS_REGION}
```
删除 Prometheus 和 Grafana 使用的 IAM 策略:
```
aws iam delete-policy --policy-arn ${AMP_POLICY_ARN}
```
删除 AMP 工作区:
```
aws amp delete-workspace --workspace-id ${AMP_WORKSPACE_ID} --region ${AWS_REGION}
```
删除监控命名空间:
```
kubectl delete namespace monitoring
```
### 清理模型权重 S3 存储桶
查找模型存储桶名称:
```
MODEL_BUCKET=$(aws s3api list-buckets \
--query "Buckets[?starts_with(Name, '${CLUSTER_NAME}-models-')].Name | [0]" \
--output text)
echo "Model bucket: ${MODEL_BUCKET}"
```
查找 IAM 策略 ARN:
```
POLICY_ARN=$(aws iam list-policies \
--scope Local \
--query "Policies[?PolicyName=='${CLUSTER_NAME}-model-storage-policy'].Arn" \
--output text)
echo "Policy ARN: ${POLICY_ARN}"
```
删除 S3 模型存储桶以及其中的所有对象:
```
aws s3 rb s3://${MODEL_BUCKET} --force
```
删除 EKS 容器组身份关联:
```
eksctl delete podidentityassociation \
--cluster ${CLUSTER_NAME} \
--namespace default \
--service-account-name model-storage-sa \
--region ${AWS_REGION}
```
删除 IAM 策略:
```
aws iam delete-policy --policy-arn ${POLICY_ARN}
```
删除 Kubernetes 服务账户:
```
kubectl delete serviceaccount model-storage-sa
```
### 删除剩余资源和集群
```
kubectl delete nodepool gpu-inf --ignore-not-found
kubectl delete nodeclass gpu-inf --ignore-not-found
kubectl delete ec2nodeclass gpu-inf --ignore-not-found
eksctl delete cluster --name=$CLUSTER_NAME --region=$AWS_REGION
```