Evaluation Metrics Formats
Evaluating the quality of your model across these metric formats:
Model Evaluation Summary
MLFlow
TensorBoard
Model Evaluation Summary
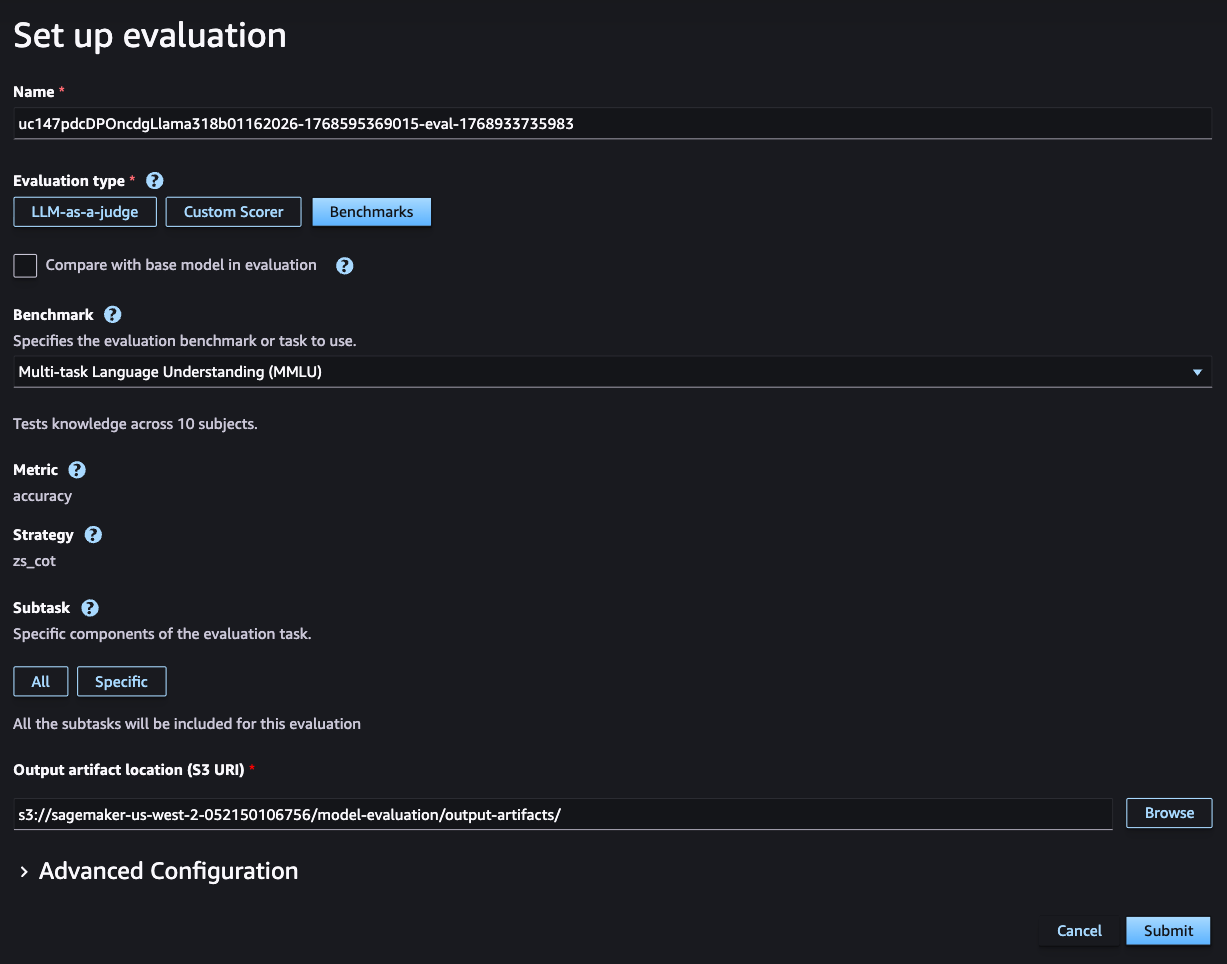
When you submit your evaluation job you specify an Amazon S3 output location. SageMaker automatically uploads the evaluation summary .json file to the location. The benchmark summary S3 path is the following:
s3://<your-provide-s3-location>/<training-job-name>/output/output/<evaluation-job-name>/eval_results/
Pass the Amazon S3 location
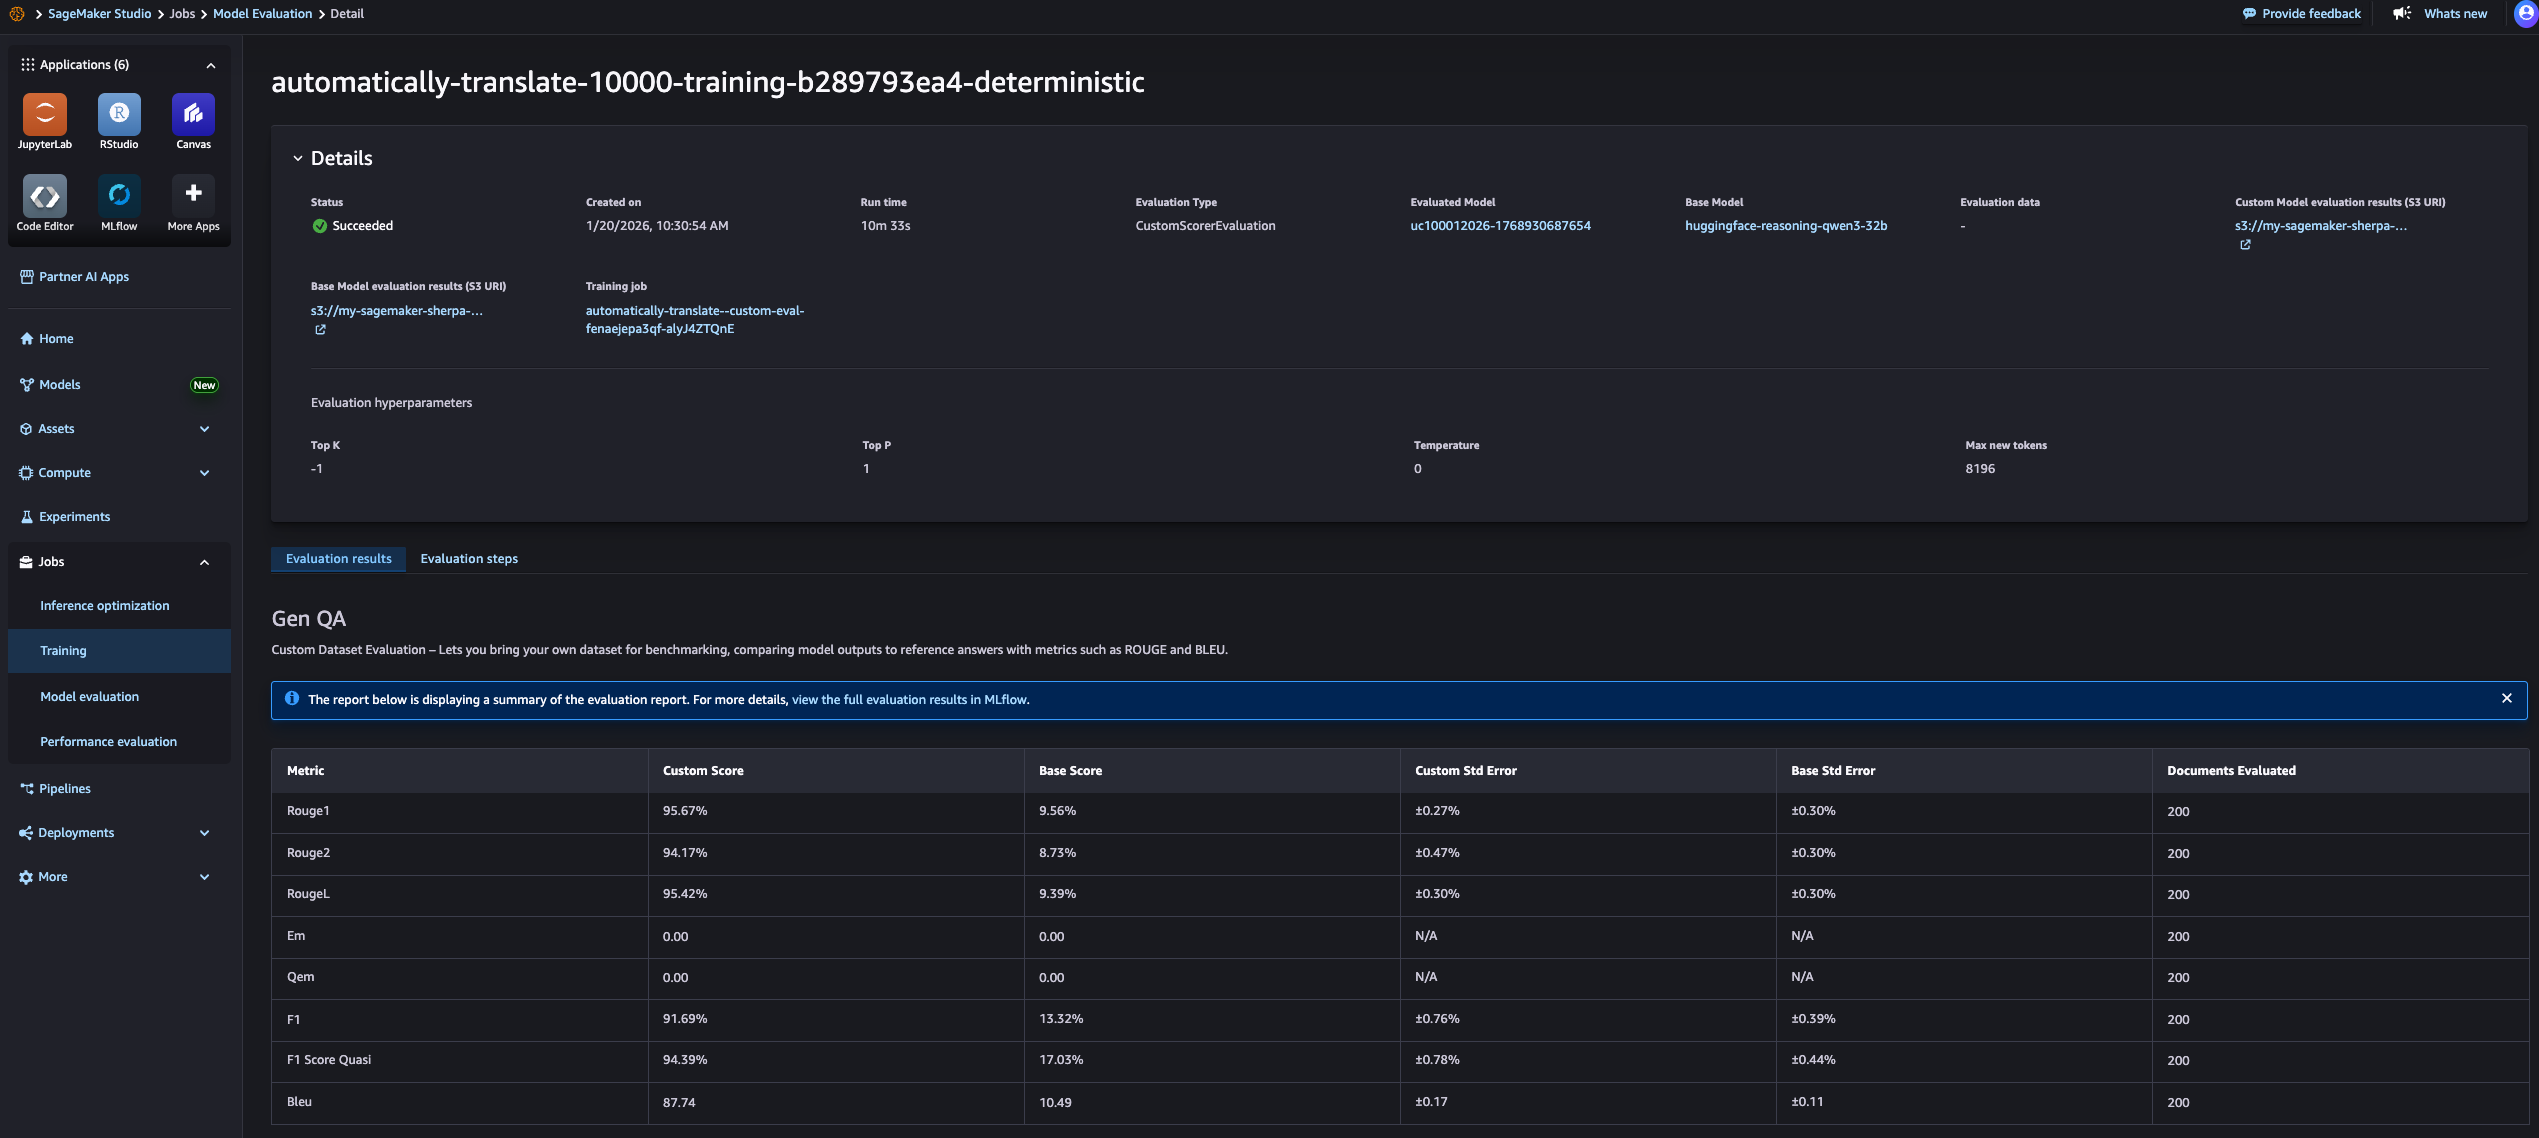
Read it directly as a .json from the Amazon S3 location or visualized automatically in the UI:
{
  "results": {
    "custom|gen_qa_gen_qa|0": {
      "rouge1": 0.9152812653966208,
      "rouge1_stderr": 0.003536439199232507,
      "rouge2": 0.774569918517409,
      "rouge2_stderr": 0.006368825746765958,
      "rougeL": 0.9111255645823356,
      "rougeL_stderr": 0.003603841524881021,
      "em": 0.6562150055991042,
      "em_stderr": 0.007948251702846893,
      "qem": 0.7522396416573348,
      "qem_stderr": 0.007224355240883467,
      "f1": 0.8428757602152095,
      "f1_stderr": 0.005186300690881584,
      "f1_score_quasi": 0.9156170336744968,
      "f1_score_quasi_stderr": 0.003667700152375464,
      "bleu": 100.00000000000004,
      "bleu_stderr": 1.464411857851008
    },
    "all": {
      "rouge1": 0.9152812653966208,
      "rouge1_stderr": 0.003536439199232507,
      "rouge2": 0.774569918517409,
      "rouge2_stderr": 0.006368825746765958,
      "rougeL": 0.9111255645823356,
      "rougeL_stderr": 0.003603841524881021,
      "em": 0.6562150055991042,
      "em_stderr": 0.007948251702846893,
      "qem": 0.7522396416573348,
      "qem_stderr": 0.007224355240883467,
      "f1": 0.8428757602152095,
      "f1_stderr": 0.005186300690881584,
      "f1_score_quasi": 0.9156170336744968,
      "f1_score_quasi_stderr": 0.003667700152375464,
      "bleu": 100.00000000000004,
      "bleu_stderr": 1.464411857851008
    }
  }
}
MLflow logging
Provide your SageMaker MLFlow resource ARN
SageMaker Studio uses the default MLFlow app that gets provisioned on each Studio domain when you use the model customization capability for the first time. SageMaker Studio uses the default MLflow app associated ARN in evaluation job submission.
You can also submit your evaluation job and explicitly provide an MLFlow Resource ARN to stream metrics to said associated tracking server/app for real time analysis.
For more information about working with managed MLflow on SageMaker AI, see Accelerate generative AI development using managed MLflow on Amazon SageMaker AI, Set up IAM permissions for MLflow, and Set up IAM permissions for MLflow Apps.
SageMaker Python SDK
evaluator = BenchMarkEvaluator(
    benchmark=Benchmark.MMLU,
    model="arn:aws:sagemaker:<region>:<account-id>:model-package/<model-package-name>/<version>",
    s3_output_path="s3://<bucket-name>/<prefix>/eval/",
    mlflow_resource_arn="arn:aws:sagemaker:<region>:<account-id>:mlflow-tracking-server/<tracking-server-name>",
    evaluate_base_model=False
)

execution = evaluator.evaluate()
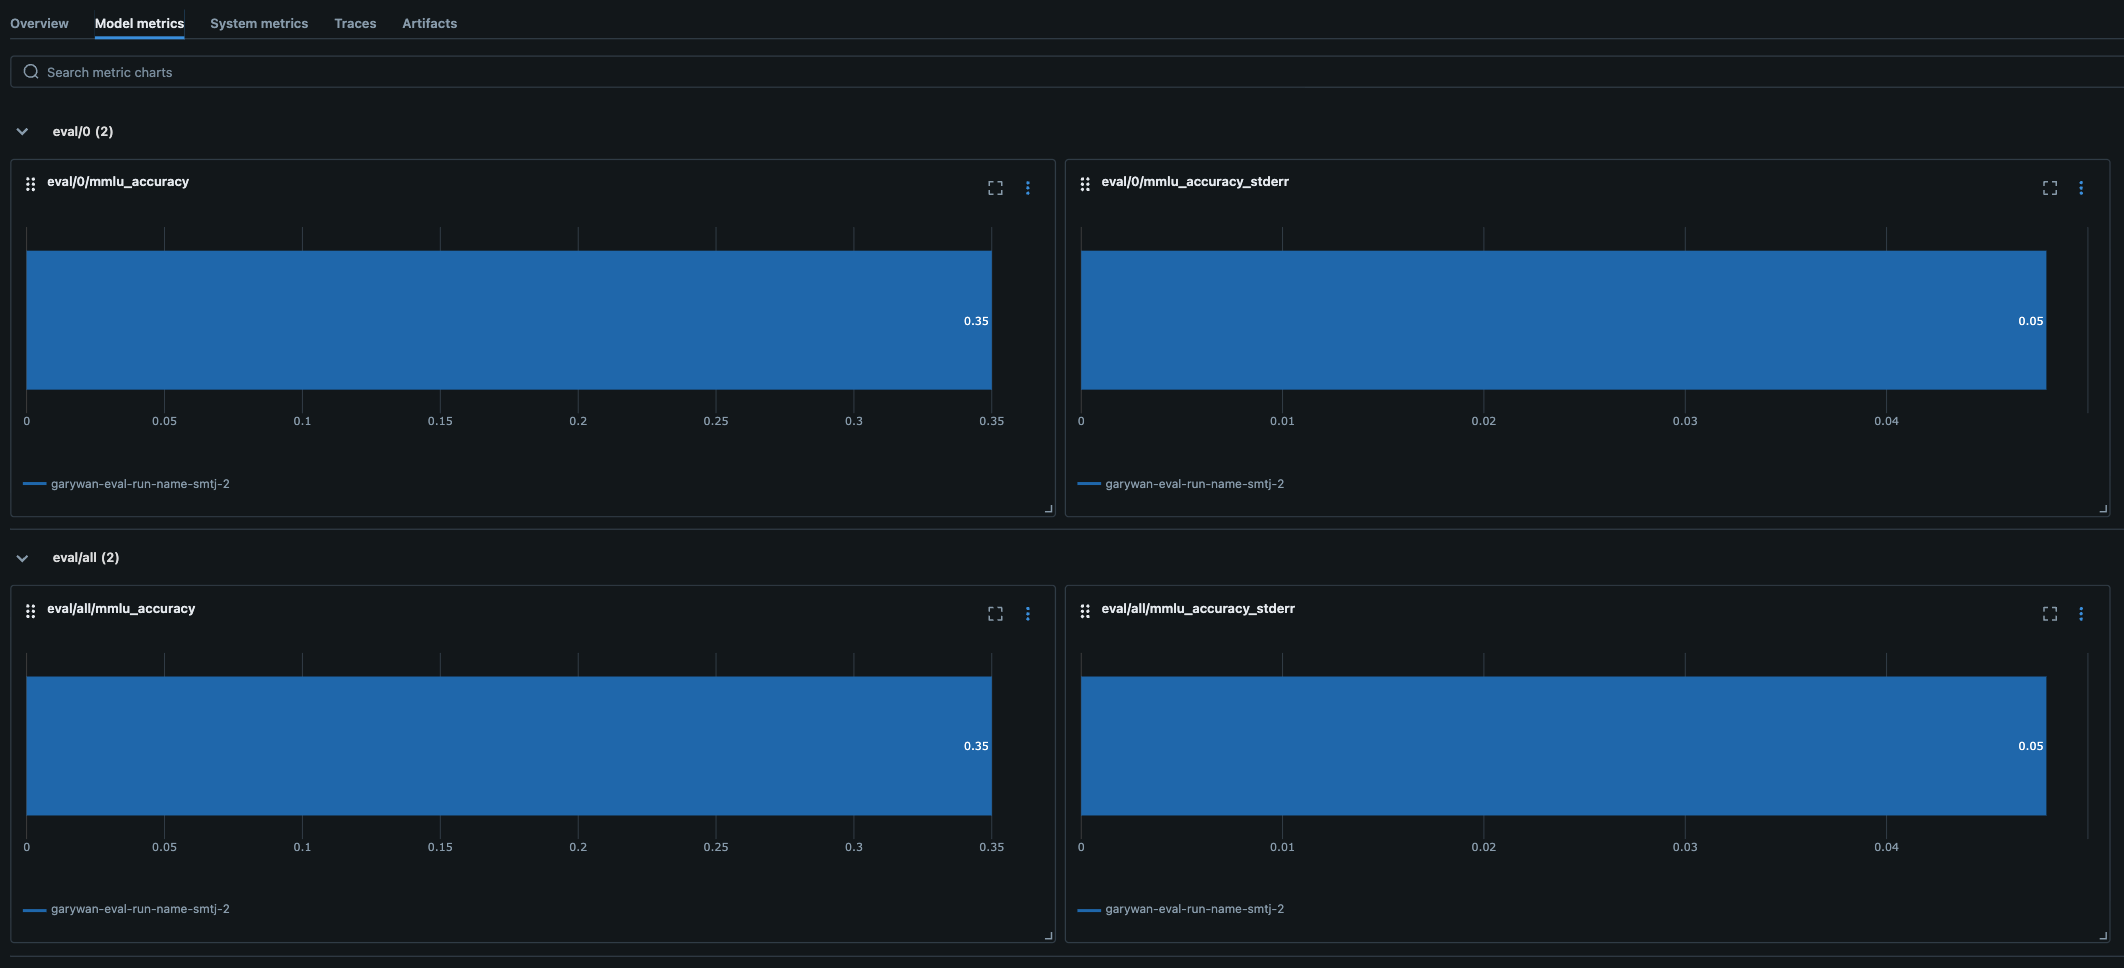
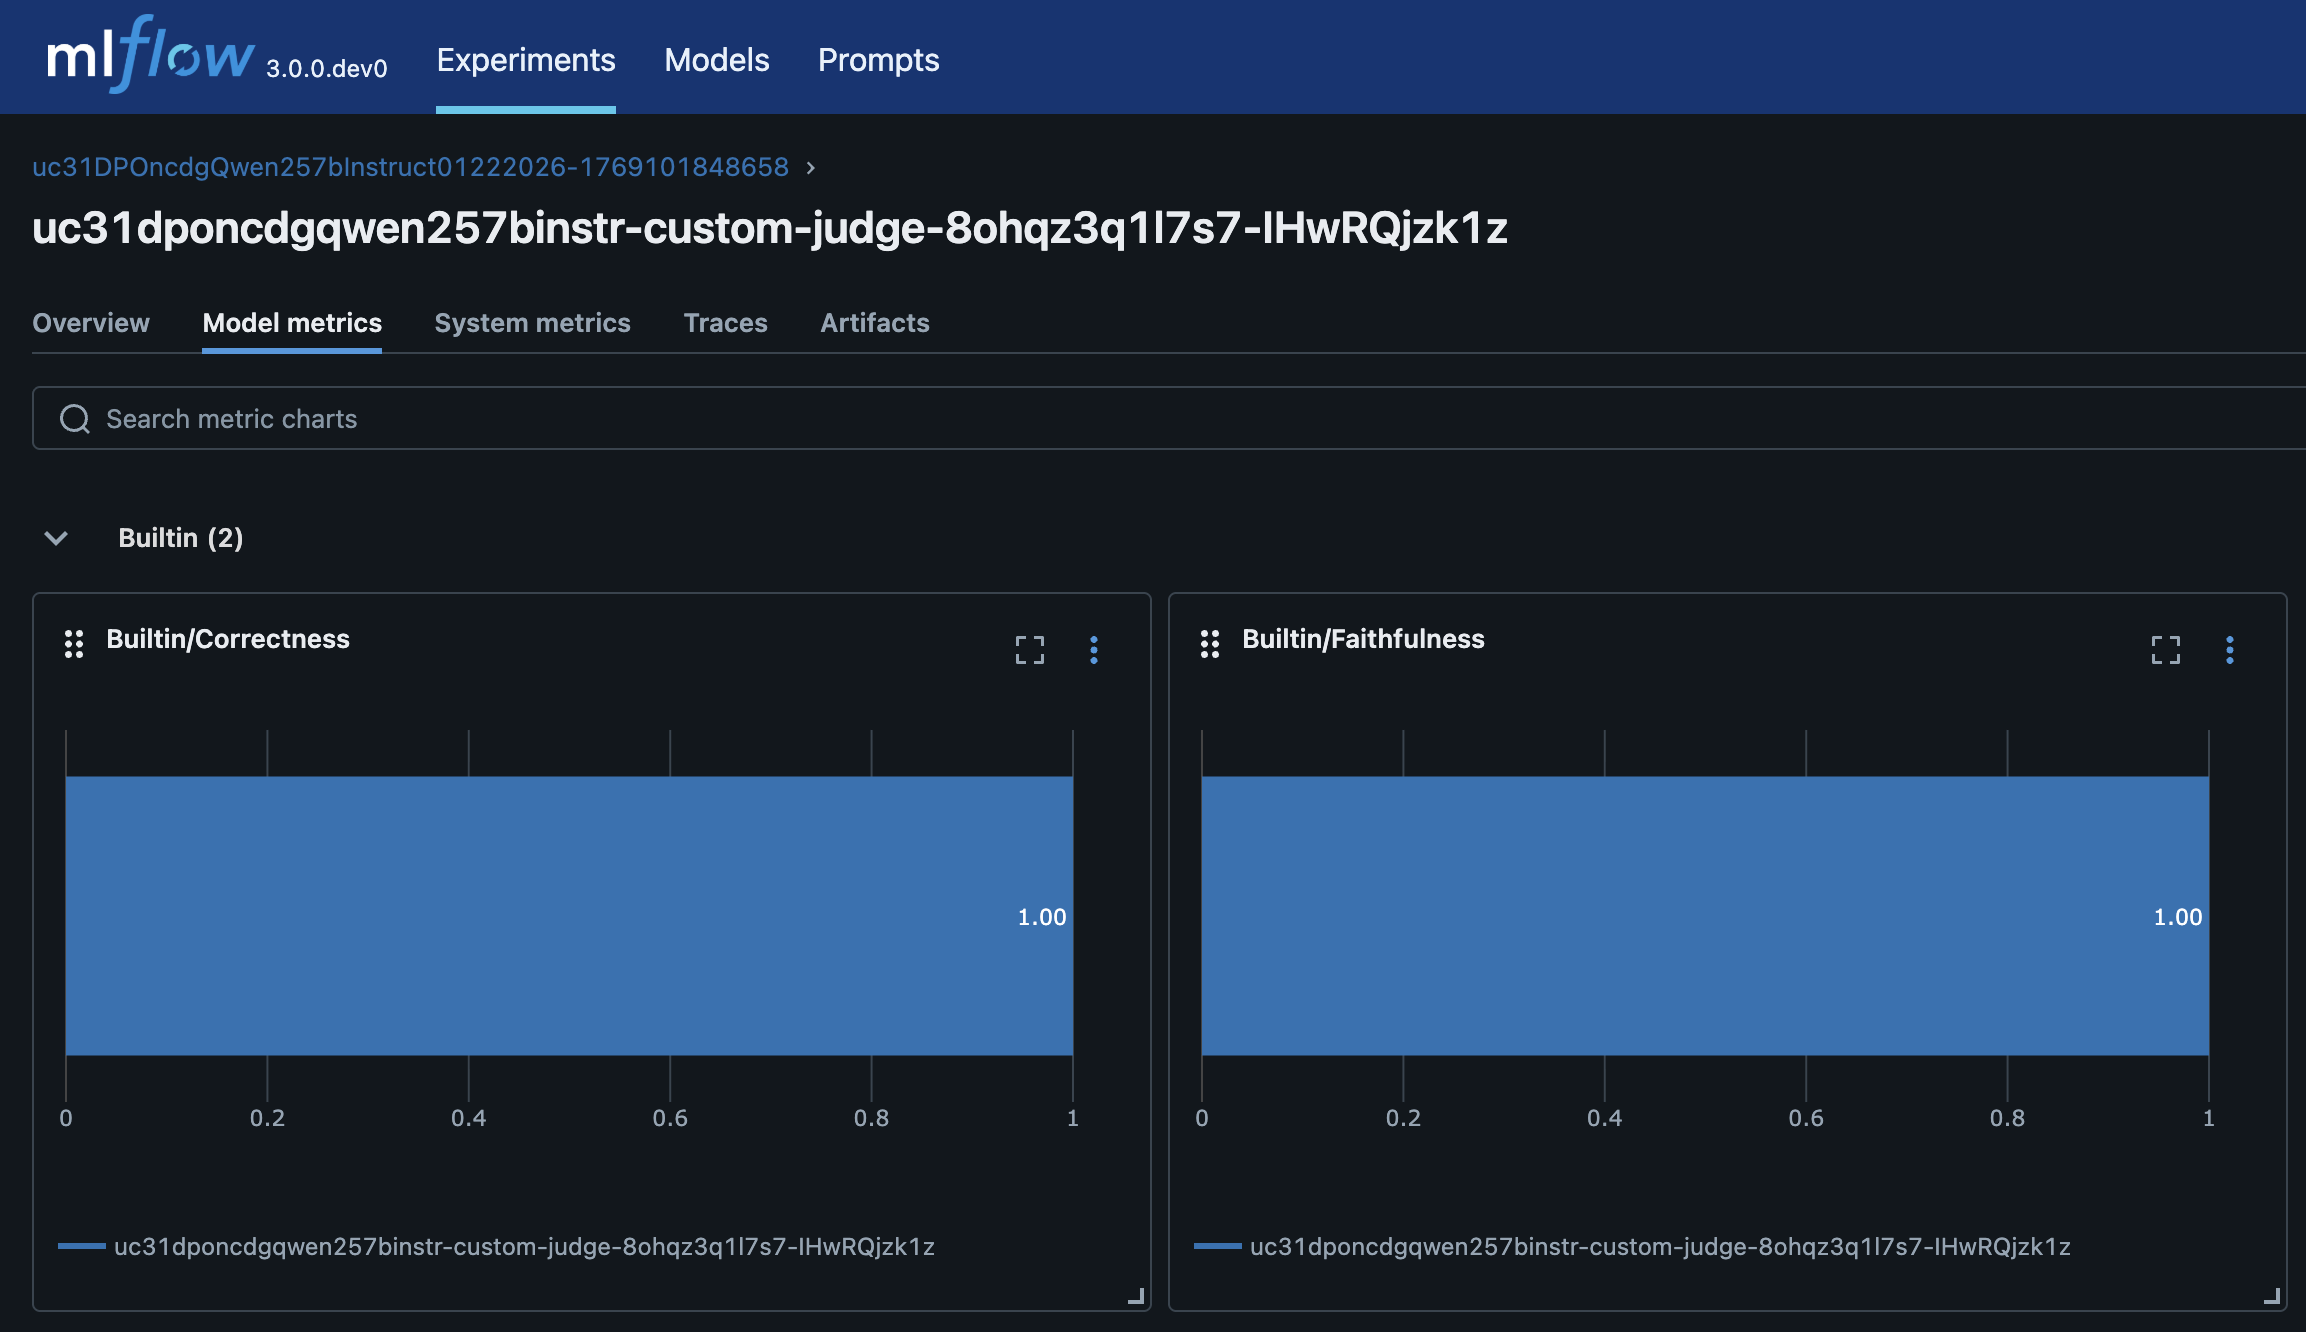
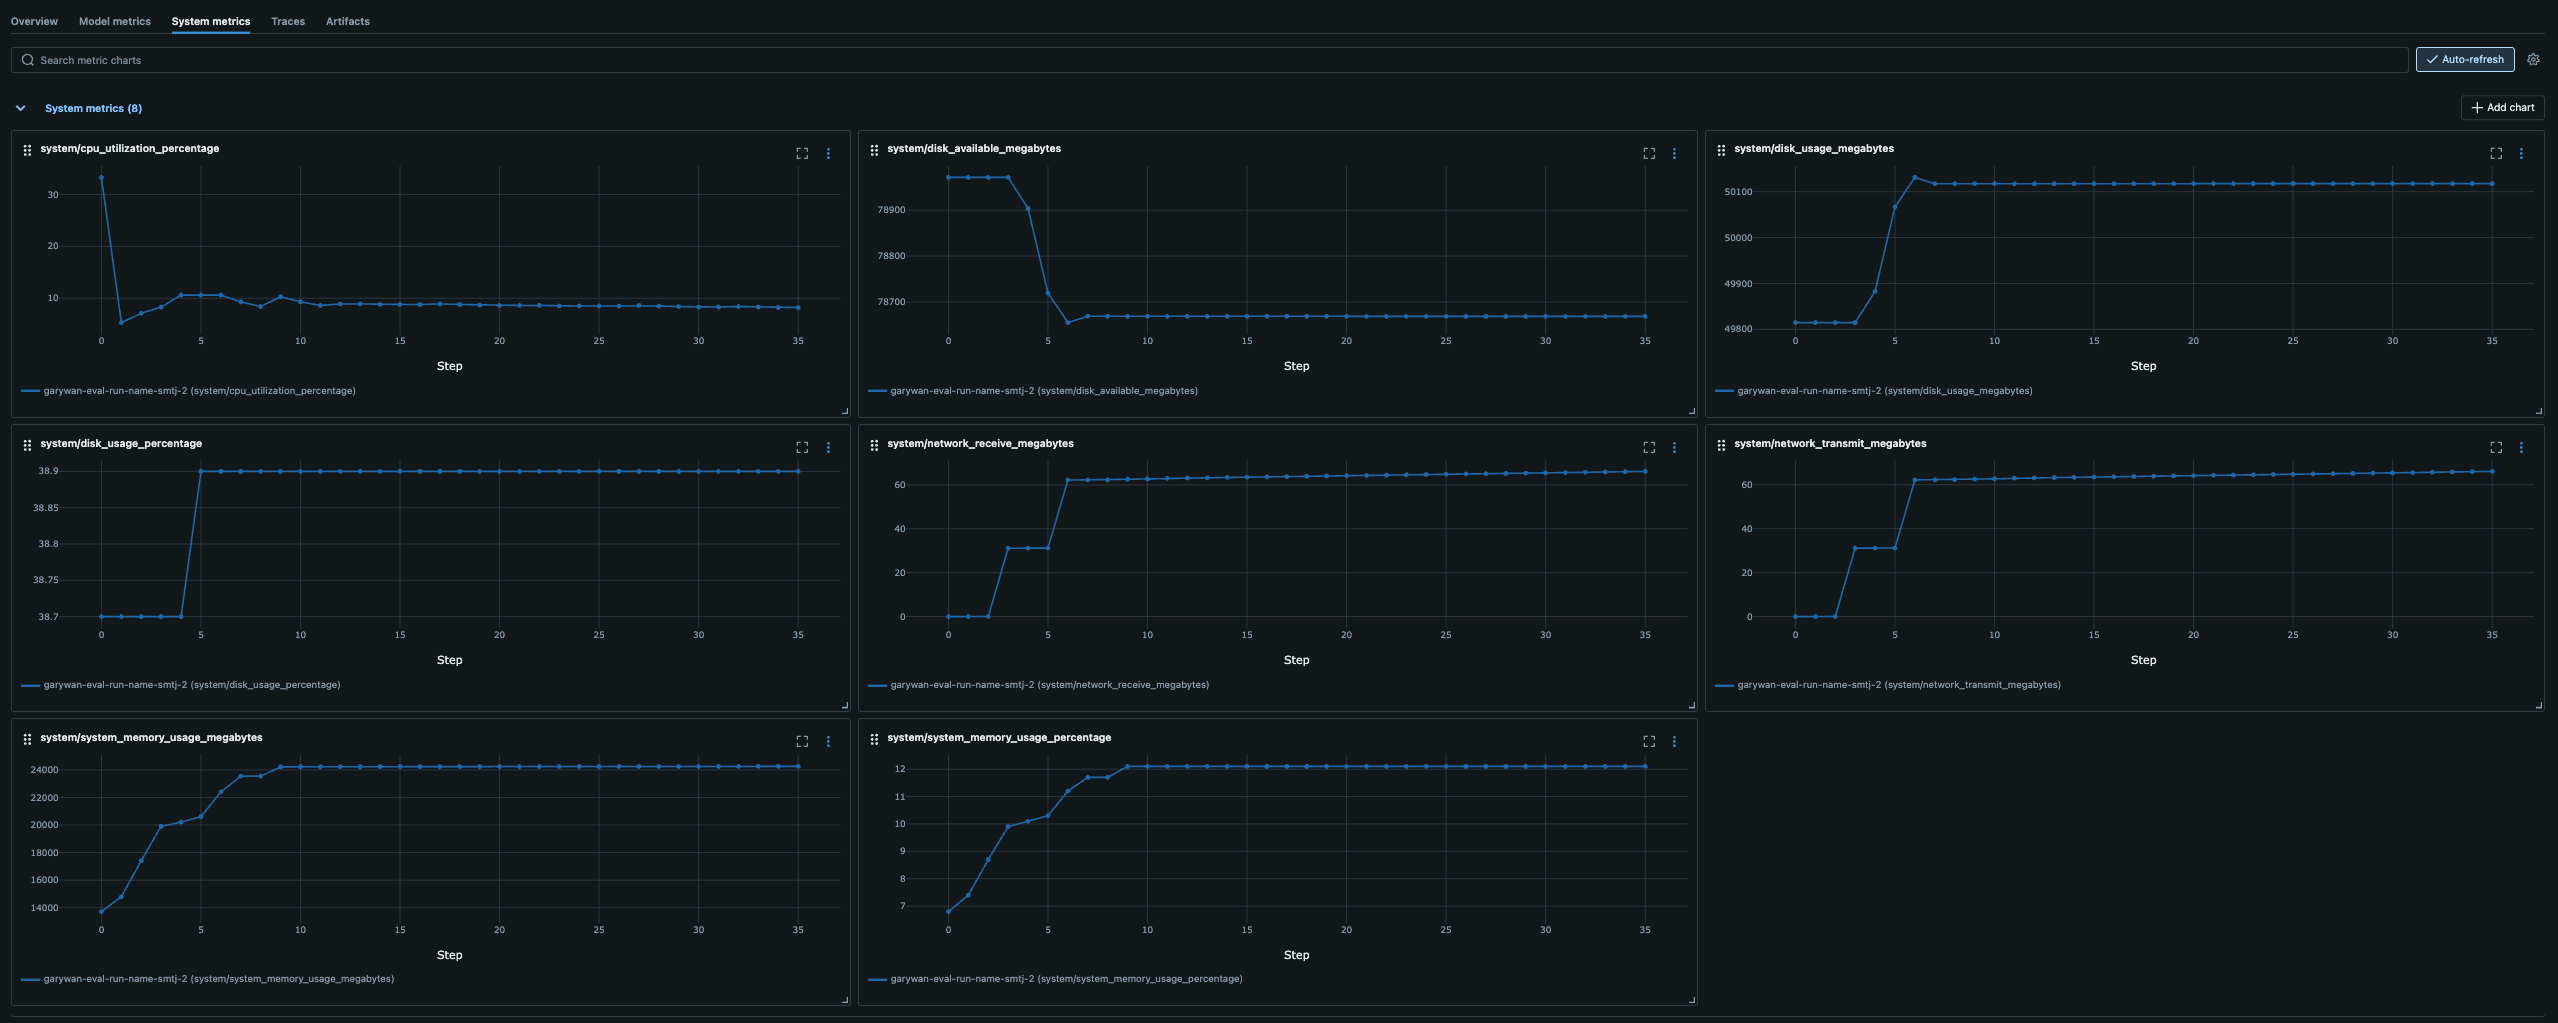
Model level and system level metric visualization:
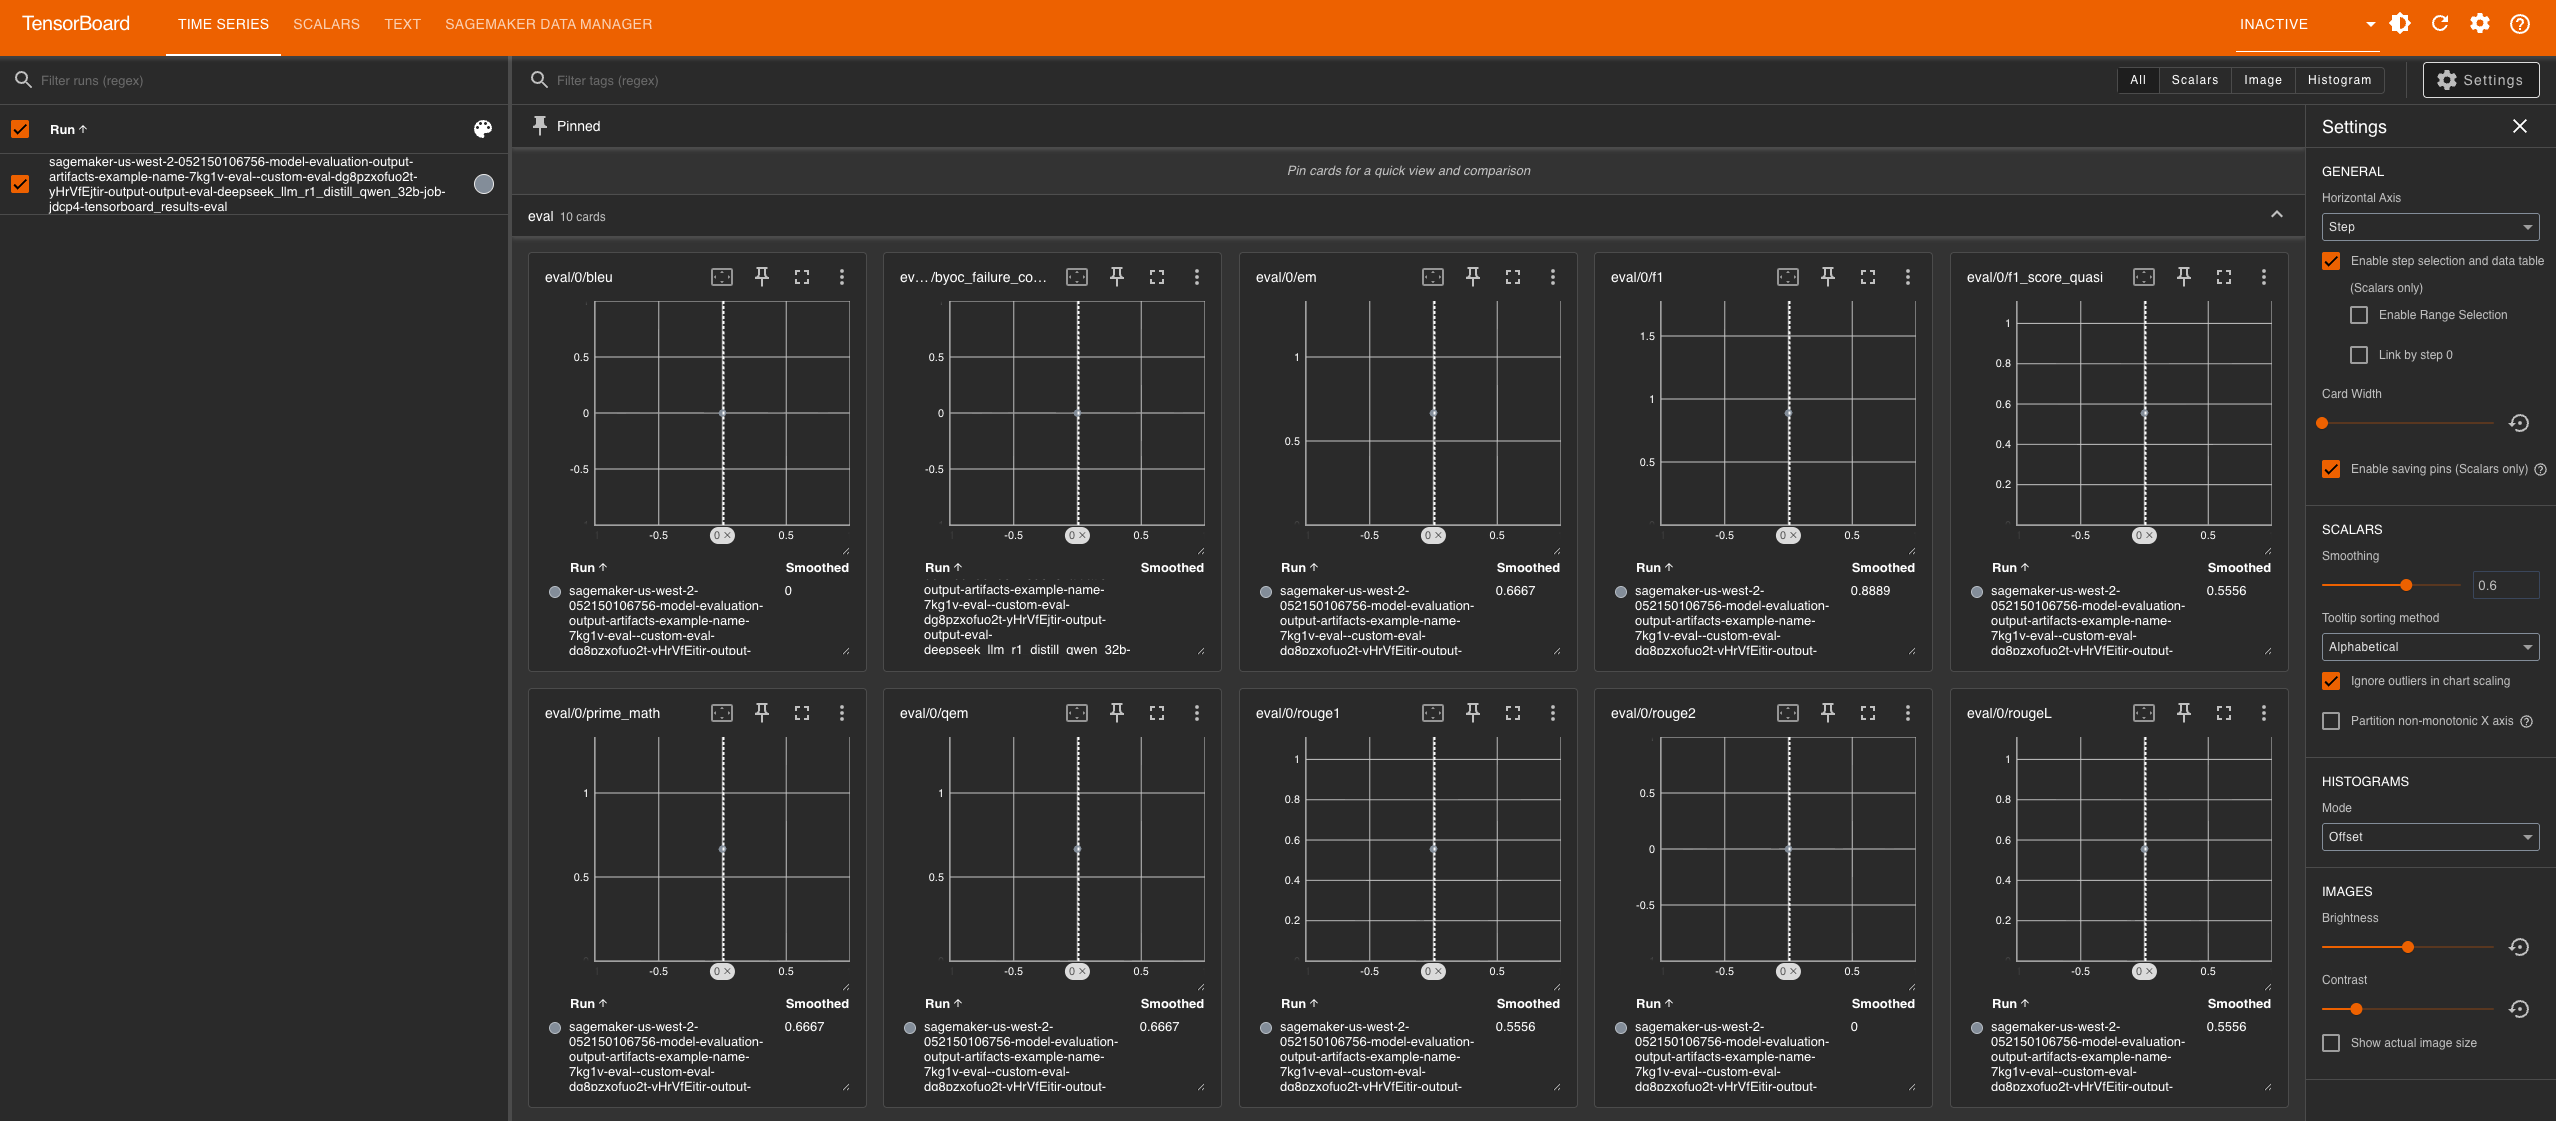
TensorBoard
Submit your evaluation job with an Amazon S3 output location. SageMaker automatically uploads a TensorBoard file to the location.
SageMaker uploads the TensorBoard file to Amazon S3 in the following location:
s3://<your-provide-s3-location>/<training-job-name>/output/output/<evaluation-job-name>/tensorboard_results/eval/
Pass the Amazon S3 location as follows
Sample model level metrics