本文属于机器翻译版本。若本译文内容与英语原文存在差异,则一律以英文原文为准。
# 问题排查
以下常见问题可以帮助您解决 Amazon SageMaker 异步推理终端节点的问题。
## 问:我启用了自动缩放。如何确定任意给定时刻在端点后台的实例数?
您可以使用以下方法查找端点后台的实例数:
+ 您可以使用 SageMaker AI [DescribeEndpoint](https://docs.amazonaws.cn/sagemaker/latest/APIReference/API_DescribeEndpoint.html)API 来描述在任何给定时间点终端节点背后的实例数量。
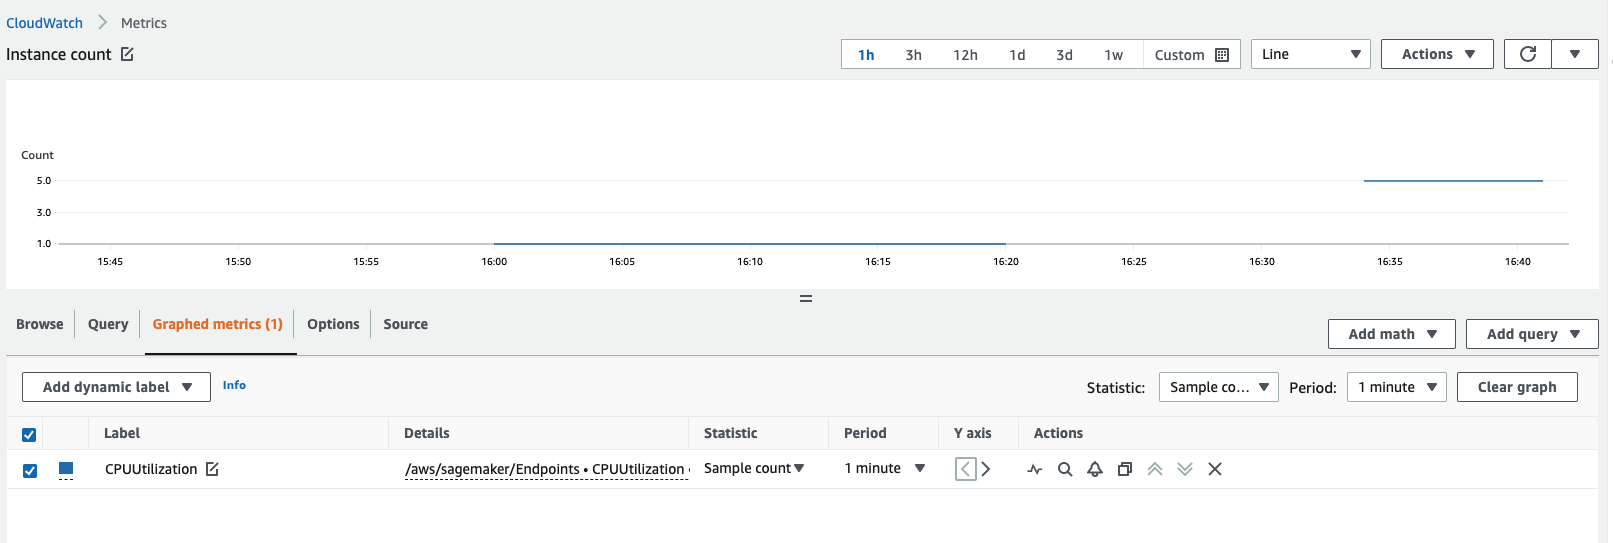
+ 您可以通过查看您的 Amazon CloudWatch 指标来获取实例数量。查看[端点实例的指标](https://docs.amazonaws.cn/sagemaker/latest/dg/monitoring-cloudwatch.html#cloudwatch-metrics-jobs),例如 `CPUUtilization` 或 `MemoryUtilization`,并查看 1 分钟时段的样本计数统计数据。该计数应等于活动实例的数量。以下屏幕截图显示了 CloudWatch 控制台中绘`CPUUtilization`制的指标,其中 “**统计数据**” 设置为`Sample count`,“**周期**” 设置为`1 minute`,结果计数为 5。
## 问: SageMaker AI 容器常见的可调环境变量有哪些?
下表按框架类型概述了 SageMaker AI 容器的常见可调环境变量。
**TensorFlow**
| 环境变量 | 说明 |
| --- | --- |
| `SAGEMAKER_TFS_INSTANCE_COUNT` | 对于 TensorFlow-based 模型,`tensorflow_model_server`二进制文件是负责将模型加载到内存中、对模型图运行输入以及派生输出的操作部分。通常,此二进制文件启动单个实例以在端点中为模型提供服务。此二进制文件在内部是多线程的,它会生成多个线程来响应单个推理请求。在某些情况下,如果您观察到 CPU 的利用率不错(利用率超过 30%),但内存的利用率不足(利用率低于 10%),则增加此参数可能会有所帮助。增加可用于提供服务的 `tensorflow_model_servers` 的数量通常会增加端点的吞吐量。 |
| `SAGEMAKER_TFS_FRACTIONAL_GPU_MEM_MARGIN` | 此参数控制要初始化的可用 GPU 内存 CUDA/cuDNN 和其他 GPU 库的比例。 `0.2`意味着 20% 的可用 GPU 内存预留用于初始 CUDA/cuDNN 化和其他 GPU 库,80% 的可用 GPU 内存在 TF 进程中平均分配。除非启用 `allow_growth` 选项,否则将预先分配 GPU 内存。 |
| `SAGEMAKER_TFS_INTER_OP_PARALLELISM` | 这可以追溯到 `inter_op_parallelism_threads` 变量。此变量确定独立非阻塞操作使用的线程数。`0` 表示系统选择了合适的数字。 |
| `SAGEMAKER_TFS_INTRA_OP_PARALLELISM` | 这可以追溯到 `intra_op_parallelism_threads` 变量。此项决定可用于某些操作的线程数,例如矩阵乘法和矩阵简化,用于提高速度。值为 `0` 表示系统选择了合适的数字。 |
| `SAGEMAKER_GUNICORN_WORKERS` | 此项控制为处理请求,Gunicorn 根据请求生成的工作线程的数量。此值与其他参数结合使用,可以得出一个能够最大限度提高推理吞吐量的集合。除此之外,`SAGEMAKER_GUNICORN_WORKER_CLASS` 还控制生成的工作线程类型,通常为 `async` 或 `gevent`。 |
| `SAGEMAKER_GUNICORN_WORKER_CLASS` | 此项控制为处理请求,Gunicorn 根据请求生成的工作线程的数量。此值与其他参数结合使用,可以得出一个能够最大限度提高推理吞吐量的集合。除此之外,`SAGEMAKER_GUNICORN_WORKER_CLASS` 还控制生成的工作线程类型,通常为 `async` 或 `gevent`。 |
| `OMP_NUM_THREADS` | Python 在内部使用 OpenMP,以在进程中实施多线程。通常,生成的线程数与 CPU 核心数相等。但是,当在同步多线程(SMT)(例如英特尔的)之上实现时 HypeThreading,某个进程可能会超额订阅特定的内核,因为生成的线程数是实际CPU内核数量的两倍。在某些情况下,Python 二进制文件最终生成的线程数量可能是可用处理器核心数的四倍。因此,如果您使用工作线程超额订阅了可用核心,则此参数的理想设置是 `1`,或者在开启了 SMT 的 CPU 上,是 CPU 核心数的一半。 |
| `TF_DISABLE_MKL`
`TF_DISABLE_POOL_ALLOCATOR` | 在某些情况下,如果 `TF_DISABLE_MKL` 和 `TF_DISABLE_POOL_ALLOCATOR` 设置为 `1`,则关闭 MKL 可以加快推理速度。 |
**PyTorch**
| 环境变量 | 说明 |
| --- | --- |
| `SAGEMAKER_TS_MAX_BATCH_DELAY` | 这是 TorchServe 等待接收的最大批量延迟时间。 |
| `SAGEMAKER_TS_BATCH_SIZE` | 如果在计时器用完`batch_size`之前 TorchServe 没有收到中指定的请求数,则会将收到的请求发送到模型处理程序。 |
| `SAGEMAKER_TS_MIN_WORKERS` | 允许缩减的最低员工人数。 TorchServe |
| `SAGEMAKER_TS_MAX_WORKERS` | 允许扩大规模的最大员工人数。 TorchServe |
| `SAGEMAKER_TS_RESPONSE_TIMEOUT` | 延迟的时间,超过该时间之后,如果没有响应,推理将超时。 |
| `SAGEMAKER_TS_MAX_REQUEST_SIZE` | 的最大有效载荷大小 TorchServe。 |
| `SAGEMAKER_TS_MAX_RESPONSE_SIZE` | 的最大响应大小 TorchServe。 |
**多模型服务器 (MMS)**
| 环境变量 | 说明 |
| --- | --- |
| `job_queue_size` | 在您的场景中,如果推理请求类型的负载很大,并且由于负载的大小过大,维护该队列的 JVM 的堆内存使用量可能会过高时,此参数对于调整很有用。理想情况下,您希望将 JVM 的堆内存需求保持在较低的水平,并允许 Python 工作线程为实际模型服务分配更多内存。JVM 仅用于接收 HTTP 请求,对其进行排队,然后将其分派给 Python-based 工作人员进行推理。如果您增加 `job_queue_size`,则最终可能会增加 JVM 的堆内存用量,并最终占用了主机中本可供 Python 工作线程使用的内存。因此,在调整此参数时也要小心谨慎。 |
| `default_workers_per_model` | 此参数用于后端模型服务,在用于调整时可能很有价值,因为这是整个模型服务的关键组件,Python 进程基于它为每个模型生成线程。如果此组件速度较慢(或调整不正确),则前端调整可能无效。 |
## 问:如何确保我的容器支持异步推理?
您可以将与用于推理或批处理转换的容器相同的容器用于异步 Real-Time 推理。您应确认已设置了容器上的超时和负载大小限制,用于处理更大的负载和更长的超时。
## 问:有哪些特定于异步推理的限制?可以调整吗?
请参阅以下异步推理的限制:
+ 负载大小限制:1 GB
+ 超时限制:一个请求最多可以需要 60 分钟。
+ 队列消息 TimeToLive (TTL):6 小时
+ 可以放入 Amazon SQS 中的消息数量:无限制。但是,对于标准队列,未送达消息数的限额为 12 万,对于 FIFO 队列为 2 万。
## 问:在异步推理中,最好为自动缩放定义哪些指标? 我可以有多个扩展策略吗?
通常,使用异步推理,您可以根据调用数或实例数横向扩展。对于调用指标,查看您的 `ApproximateBacklogSize` 是一种好的做法,该指标定义队列中尚未处理的项目数量。您可以利用这个指标或 `InvocationsPerInstance` 指标来了解您可能被限制的 TPS 是多少。在实例级别,检查您的实例类型及其 CPU/GPU 利用率,以定义何时进行扩展。如果单个实例的容量超过 60-70%,这通常是一个好的迹象,表明您充分利用了硬件。
我们不建议使用多个扩展策略,因为这些策略可能会在硬件层面发生冲突并导致混乱,从而导致横向扩展时出现延迟。
## 问:为什么我的异步终端节点以 “运行`状况不`佳” 为由终止实例,而来自自动扩缩的更新请求却失败了?
检查您的容器是否能够同时处理 ping 和调用请求。 SageMaker AI 调用请求大约需要 3 分钟,在这段时间内,由于超时导致 SageMaker AI 检测到您的容器,通常多个 ping 请求最终会失败`Unhealthy`。
## 问:使用 ningx/gunicorn /flask 设置可以`MaxConcurrentInvocationsPerInstance`用于我的 BYOC 模型容器吗?
可以。`MaxConcurrentInvocationsPerInstance` 是异步端点的一项功能。这不依赖于自定义容器实施。`MaxConcurrentInvocationsPerInstance` 控制向客户容器发送调用请求的速率。如果将此值设置为 `1`,则无论客户容器上有多少个工作线程,一次只会向容器发送一个请求。
## 问:如何调试异步端点上的模型服务器错误 (500)?
该错误意味着客户容器返回了错误。 SageMaker AI 无法控制客户容器的行为。 SageMaker AI 只返回来自的响应`ModelContainer`,不会重试。如果需要,您可以配置调用以在失败时重试。我们建议您打开容器日志记录并检查容器日志,找出模型中出现 500 错误的根本原因。还应检查出现故障时的对应 `MemoryUtilization` 和 `CPUUtilization` 指标。您也可以在 Amazon SNS 中[S3FailurePath](https://docs.amazonaws.cn/sagemaker/latest/APIReference/API_AsyncInferenceOutputConfig.html#sagemaker-Type-AsyncInferenceOutputConfig-S3FailurePath)将模型响应配置为异步错误通知的一部分,以调查故障。
## 问:我怎么知道 `MaxConcurrentInvocationsPerInstance=1` 是否生效? 可以检查哪些指标?
您可以检查指标 `InvocationsProcesssed`,该指标应与您根据单次并发度,预计的一分钟内调用次数保持一致。
## 问:如何跟踪我的调用请求成功还是失败? 最佳实践是什么?
最佳实践是启用 Amazon SNS,这是一项是面向消息收发应用程序的通知服务,多个订阅用户可以选择通过多种传输协议(包括 HTTP、Amazon SQS 和电子邮件)请求和接收注重时效消息的“推送”通知。当您使用 `CreateEndpointConfig` 创建端点并指定 Amazon SNS 主题时,异步推理会发布通知。
要使用 Amazon SNS 检查异步端点的预测结果,您首先需要创建一个主题,订阅并确认订阅该主题,然后记下该主题的 Amazon 资源名称 (ARN)。有关如何创建、订阅和查找 Amazon SNS 主题的 Amazon ARN 的详细信息,请参阅《Amazon SNS 开发人员指南》**中的[配置 Amazon SNS](https://docs.amazonaws.cn/sns/latest/dg/sns-configuring.html)。有关如何将 Amazon SNS 与异步推理结合使用的更多信息,请参阅[查看预测结果](https://docs.amazonaws.cn/sagemaker/latest/dg/async-inference-check-predictions.html)。
## 问:我能否定义一个在收到新请求时从零个实例开始纵向扩展的扩展策略?
可以。异步推理提供了一种机制,可以在没有请求时缩减到零个实例。如果您的端点在这段时间内已缩减为零个实例,则直到队列中的请求数超过扩展策略中指定的目标时,您的端点才会再次纵向扩展。这可能会导致队列中请求的等待时间过长。对于这种情况,如果您想在新请求数低于所指定的队列目标时,从零个实例开始纵向扩展,您可以使用名为 `HasBacklogWithoutCapacity` 的额外扩展策略。有关如何定义此扩展策略的更多信息,请参阅[自动缩放异步端点](https://docs.amazonaws.cn/sagemaker/latest/dg/async-inference-autoscale.html#async-inference-autoscale-scale-up)。
## 问:我收到一条错误消息,说明异步推理不支持该实例类型。异步推理支持哪些实例类型?
有关每个区域的异步推理支持的实例的详尽列表,请参阅[SageMaker 定价](https://www.amazonaws.cn/sagemaker/pricing/)。在继续操作之前,请检查所需的实例在您的地区是否可用。