本文属于机器翻译版本。若本译文内容与英语原文存在差异,则一律以英文原文为准。
# Amazon Kinesis Data Streams 的流式传输表和 S3 交付
借助 Amazon Kinesis Data Streams,您可以将来自 Kinesis 数据流的流数据传输到两种目标类型:Apache Iceberg 上的流式传输表(亚马逊 S3 表)或通用的 Amazon S3 存储桶。您无需管理任何基础架构,只需几分钟即可开始交付。Amazon Kinesis Data Streams 从您的数据流中读取数据、缓冲和聚合记录,然后将其传送到您配置的目的地。交付是完全托管的 — 无需配置连接器、消费者应用程序或计算资源。
在 On-Demand Advantage 或 On-Demand Standard 容量模式下运行的直播支持这些功能。您可以配置直播中的传送并指定目的地。然后,Amazon Kinesis Data Streams 会自动处理扩展、重试和交付可靠性。交付不会消耗直播的读取吞吐量,也不会对现有使用者产生任何影响。
**Topics**
+ [数据交付的工作原理](#data-delivery-how-it-works)
+ [送货目的地](#data-delivery-destinations-overview)
+ [数据流](#data-delivery-data-flow)
+ [关键功能](#data-delivery-capabilities)
+ [要求](#data-delivery-requirements-overview)
+ [数据交付概念](data-delivery-concepts.md)
+ [直播表](data-delivery-st.md)
+ [亚马逊 S3 一般用途交付](data-delivery-s3.md)
+ [用于数据传输的 IAM 权限](data-delivery-iam.md)
+ [数据传输的安全性](data-delivery-security.md)
+ [监控数据交付](data-delivery-monitoring.md)
+ [数据交付的最佳实践](data-delivery-best-practices.md)
+ [数据传输疑难解答](data-delivery-troubleshooting.md)
+ [配送配额和限制](data-delivery-quotas.md)
## 数据交付的工作原理
数据交付通过托管管道将您的 Kinesis 数据流连接到交付目的地:
1. 您可以在模式下将数据发布到 Kinesis 数据流。 On-Demand
1. 您可以调用`CreateChannel`直播并指定目标(Apache Iceberg 上的流式传输表或通用的 Amazon S3 存储桶)。
1. 交付从流中读取,缓冲记录,并将它们聚合到大小最优的文件中。
1. 交付将在您指定的数据新鲜度窗口内将文件写入您配置的目的地。
## 送货目的地
数据传输支持两种目标类型:
在 Apache Iceberg 上直播牌桌
流式传输表会持续将您的 Kinesis 数据流传输到存储在 Amazon S3 表中的 Apache Iceberg 表中。当数据到达时,它会自动转换为经过优化的 Apache Parquet 格式,具有智能内联压缩功能,从而消除了小文件问题并降低了下游查询成本。在数据发布到您的直播后的几分钟内,即可通过亚马逊 Athena、亚马逊 EMR、适用于 Apache Flink 的亚马逊托管服务或任何支持 Apache Iceberg 的引擎进行查询。
通用亚马逊 S3 存储桶
Amazon S3 交付将来自您的 Kinesis 数据流的流数据直接写入 S3 存储桶。记录以其原始源格式交付,不进行任何转换。使用可配置的压缩和通过输出密钥模板定义的 S3 密钥结构,将多个记录缓冲并批处理成大小最优的对象。这非常适合原始日志存档、事件重播和下游批处理等用例,在这些用例中,您需要持久、低成本地存储流数据,而无需管理交付管道的开销。
## 数据流
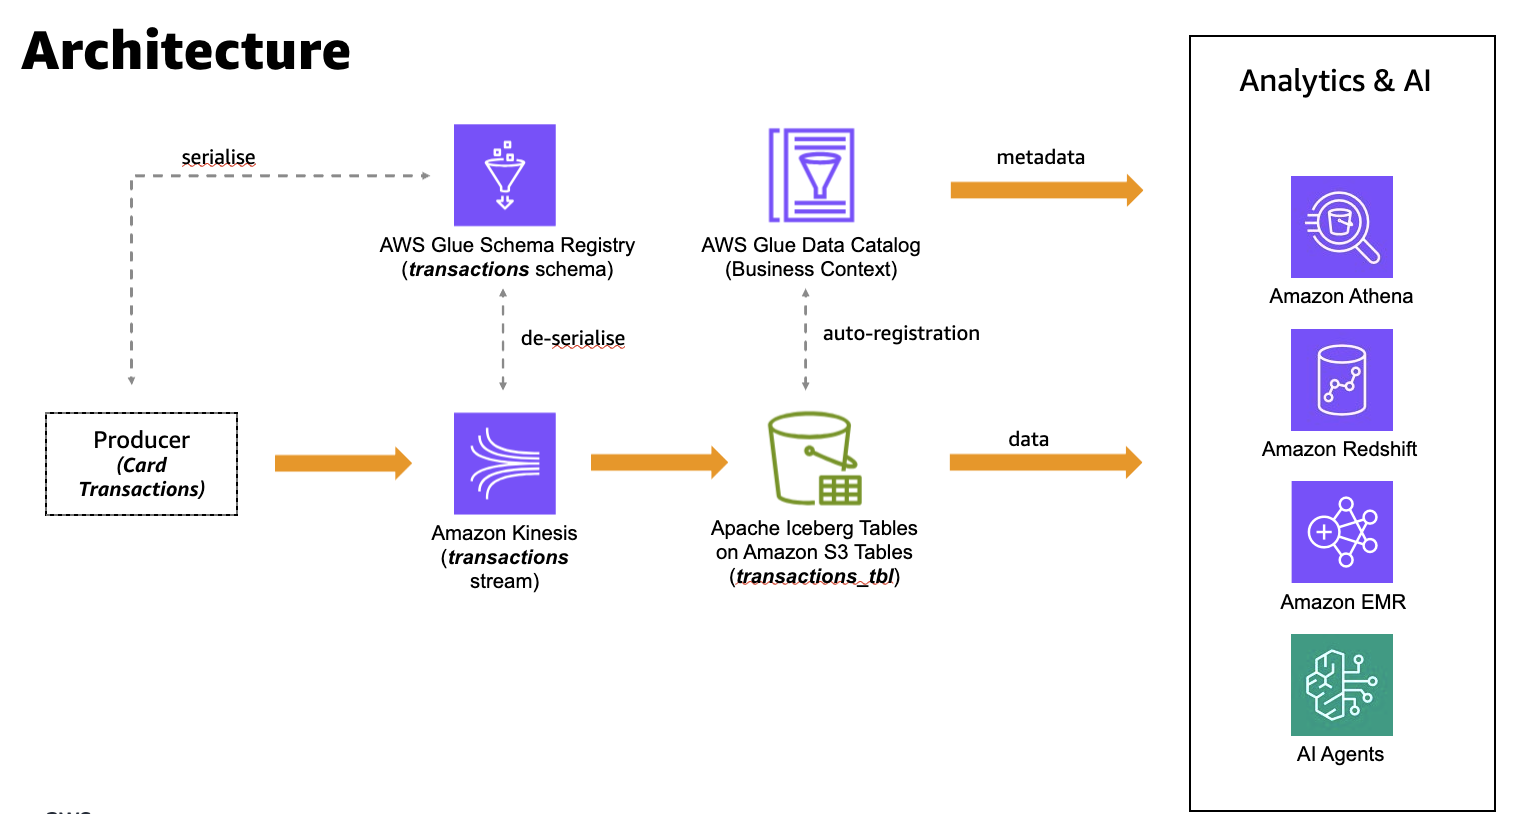
下图显示了传送到 Apache Iceberg 上的流式表的端到端数据流。该图以信用卡交易用例为例。生产者根据架构注册表中的 Amazon Glue 架构对记录进行序列化,并将它们写入 Kinesis 数据流。Amazon Kinesis Data Streams 将记录传送到亚马逊 S3 表上的 Apache Iceberg 表。如果您在 S3 表中启用分析集成,则表元数据也会在 Amazon Glue 数据目录中注册;默认情况下不会发生这种情况。然后,交付的数据及其元数据可供分析和人工智能引擎使用,例如亚马逊 Athena、Amazon Redshift 和 Amazon EMR。
向通用型 Amazon S3 存储桶的交付遵循类似的流程,但有两个区别。创建者将记录写入 Kinesis 数据流,然后 Amazon Kinesis Data Streams 将其传输到你的 S3 存储桶。记录以其原始源格式交付,无需转换,因此不需要 Amazon Glue 架构注册表,也不会在数据目录中注册表元 Amazon Glue 数据。Amazon Kinesis Data Streams 将记录缓冲区并批处理成大小最优的对象,并使用您通过输出密钥模板定义的 S3 密钥结构将其写入。然后,交付的对象可用于下游的批处理和分析。
## 关键功能
数据传输提供以下关键功能:
+ **Serverless** auto-scaling — 根据您的流吞吐量自动扩展,最高可达流的吞吐量容量。没有可供配置的计算资源。
+ **Exactly-once 按分片传送** — 来自分片的记录仅传送到目的地一次,分片内没有重复或遗漏。
+ **近乎实时的交付** — 可配置的数据新鲜度为 5 到 15 分钟(300 到 900 秒)。
+ **自动 Parquet 转换** — 对于 Apache Iceberg 上的流媒体表,可将流媒体记录转换为优化的 Apache Parquet 格式,以实现高效的分析查询
+ **内联压缩**-将记录聚合到大小最优的文件中,以提高分析查询性能。
+ **加密**-支持客户管理的 Amazon KMS 密钥在目标服务器端加密。 Amazon 托管式密钥 (`aws/kinesis`别名)不支持目标加密。
+ **Dead-letter queu** e — 无法传送的记录的故障元数据(包括流 ARN、分片 ID、序列号和错误上下文)被写入死信队列。 S3-based
+ **CloudWatch 指标和日志** — 通过 Amazon CloudWatch 指标监控传输的字节数、记录计数和数据新鲜度。启用 Amazon CloudWatch Logs 的传送日志,以捕获配送批次详情、失败和错误背景以进行故障排除。
+ 对@@ **其他使用者没有影响**-不消耗增强的扇出插槽或共享吞吐量。
## 要求
数据传输有以下要求:
+ 您的 Kinesis 数据流必须使用 On-Demand 标准或 On-Demand 优势容量模式。
+ 您必须创建一个 IAM 服务执行角色来授予写入目标的交付权限。
+ 您的目标存储桶或表存储桶必须与您的 Kinesis 数据流位于同一区域。数据传输不支持任何一种目的地类型的跨区域传输。
+ 对于 Apache Iceberg 上的直播表,不支持跨账户传输。源流、目标 S3 表存储桶和 Amazon Glue 架构注册表必须全部位于相同 Amazon Web Services 账户 且相同的区域。
+ 对于一般用途 Amazon S3 存储桶,仅目标存储桶支持跨账户传输。频道及其源流必须相同 Amazon Web Services 账户;只有目标存储桶可以位于不同的账户中。
+ 要在 Apache Iceberg 上直播表,您必须在 Amazon S3 中配置死信队列。