本文属于机器翻译版本。若本译文内容与英语原文存在差异,则一律以英文原文为准。
管理数据工作流程
场景发现中的重要数据管道概念
本节涵盖场景发现中与数据管道相关的重要概念。数据管道及其组成任务为您提供了一种灵活的容器化方法,可以对数据执行任意任务,并存储、检索场景发现功能或与之交互。您可以将管道和任务绑定到工作区并在那里定义它们。了解这些概念使您能够更有效地使用系统。
管道
管道是您在有向无环图 (DAG) 中汇编的一系列数据任务。任务在图中以节点表示,是单独的逻辑单元,它们对其输入数据执行某种处理,可以提供输出数据或元数据供后续节点使用。管道可以包含一个或多个节点。您可以并行、串联或两者组合组装节点。逐级执行:所有任务在单一级别上运行,直到达到终端状态,然后系统会继续到 DAG 中的下一层。如果关卡中有任何单个节点出现故障,则完整 DAG 的执行将停止。
富集
充实是场景发现使用适合领域的人工智能模型分析您的机载视频数据以自动提取有意义的行为和对象的过程。在充实过程中,Scenario Discovery 可识别常见的行业视频数据格式,并运用 AI-powered 理解来识别数据中的对象、事件、环境条件和关系。充实完成后,您的数据将变得完全可搜索和发现,从而使您能够使用自然语言查询、获得主动建议并利用全套场景发现管理功能。
管道共享临时存储
管道任务可以访问安装在上的共享临时存储。/var/tmp/data该存储在管道执行期间可用,并提供同一管道中的任务之间的共享访问权限。共享存储中的数据是临时的,在管道完成后不会保留。
任务
任务是场景发现数据管道的基本功能单元。任务是容器化软件逻辑,用于处理、检索或以其他方式与场景发现功能进行交互。您可以将任务打包为容器镜像,场景发现要求可以从 Amazon Elastic 容器注册表 (https://aws.amazon.com/ecr/
环境变量
您可以在任务和管道中使用环境变量在执行时将参数传递给容器化映像。您可以在创建时定义环境变量,也可以选择在执行时对其进行修改。您可以使用模板化的运行时输入定义可重用的原子任务,然后将其进一步组合成模板化管道。目标是定义一系列有用的处理操作一次,然后重复使用它们。场景发现中的环境变量的工作方式与传统容器化应用程序中的环境变量相同。
环境变量优先级
系统在运行时解析环境变量并将其记录在执行实例中。优先顺序遵循以下模式:管道环境变量优先于任务环境变量,执行时更改优先于创建时定义。例如,假设您在名为 “load_data” 的任务S3_PATH中定义了一个名为 “load_data” 的变量。接下来,定义一个名为 “ingest_processing” 的管道,该管道包含此任务并定义相同的S3_PATH环境变量。运行时使用的最终值是来自管道的值S3_PATH,而不是任务的S3_PATH值。如果您在执行时更改了任务S3_PATH,则其优先级高于原始管道S3_PATH。而且,如果您在执行时S3_PATH在管道级别进行修改,则优先于该环境变量的任何其他定义。
使用容器、任务和管道的先决条件
将数据从 Amazon S3 传输到管道存储
管道任务访问安装在的共享存储空间中的数据/var/tmp/data。您必须将源数据从 Amazon S3 传输到此位置,然后管道任务才能对其进行处理。
将您的数据从 Amazon S3 提取到 Amazon IoT SiteWise
您可以使用 CreateBulkImportJob API 将 MP4 视频、Parquet 遥测和 OpenLabel 注释文件从 Amazon S3 中提取到 Scenario Discovery 中, Amazon IoT SiteWise 用于场景发现。在调用此 API 之前,您必须在账户上启用预热层(每次设置一次 account/region)并配置两个 IAM 角色:一个 Amazon IoT SiteWise 假定读取您的 S3 对象和编写错误报告,另一个由您的调用身份用于调用 API 和传递服务角色。您可以为每种文件类型定义一致的别名,这样 Scenario Discovery 就可以关联来自同一事件的视频、遥测和注释。你可以通过 Amazon CLI、boto3 Python 软件开发工具包或原始 HTTPS(使用 SigV4 签名)调用 API,然后通过轮询DescribeBulkImportJob终端状态来验证任务已完成。有关分步说明、IAM 策略示例、请求有效负载和代码示例,请参阅CreateBulkImportJob 用于场景发现。
丰富视频以供搜索
您可以使用 CreateEnrichmentJob API 来分析已经摄入的视频时间序列数据, Amazon IoT SiteWise 并生成嵌入式数据,从而对该视频中的事件进行语义(自然语言)搜索。这是自然而然的后续行动CreateBulkImportJob:将MP4视频放入场景发现数据集后,你打电话CreateEnrichmentJob让该视频可供查询。在提交任务之前,您需要一个活动的 Scenario Discovery 工作空间和包含目标视频的数据集,并且您的呼叫身份必须具有 Amazon IoT SiteWise 丰富任务权限(如果工作空间使用客户管理的密钥,则还必须具有 KMS 解密访问权限)。您可以将每个作业的范围限定为单个视频时间序列(由其属性别名标识),并定义处理的时间窗口。你可以通过 Amazon 命令行界面、boto3 Python 软件开发工具包或原始 HTTPS(使用 SigV4 签名)调用 API,然后通过轮询来验证是否完成,DescribeEnrichmentJob直到它达到终端状态。有关分步说明、IAM 策略示例、请求有效负载和代码示例,请参阅CreateEnrichmentJob 用于场景发现。
使用任务和管道处理和摄取数据
场景发现使用任务和管道来处理和摄取您的数据。任务在托管计算上运行容器(您的自定义代码)。管道将多个任务链接到一个自动化的工作流程中。本部分将引导您创建任务、构建管道、运行管道以及使用示例验证数据是否已采集。
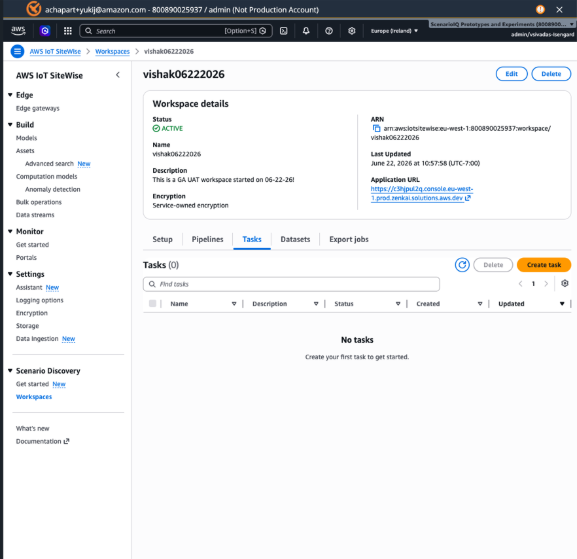
步骤 1:导航到 “任务” 选项卡
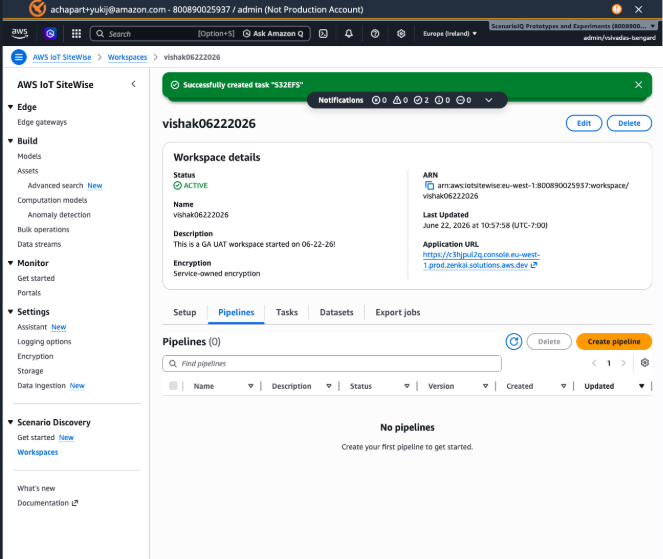
在您的工作空间中,选择 “任务” 选项卡。您可以在这里管理所有容器任务。如果您尚未创建任何任务,则该列表为空。
第 2 步:创建新任务
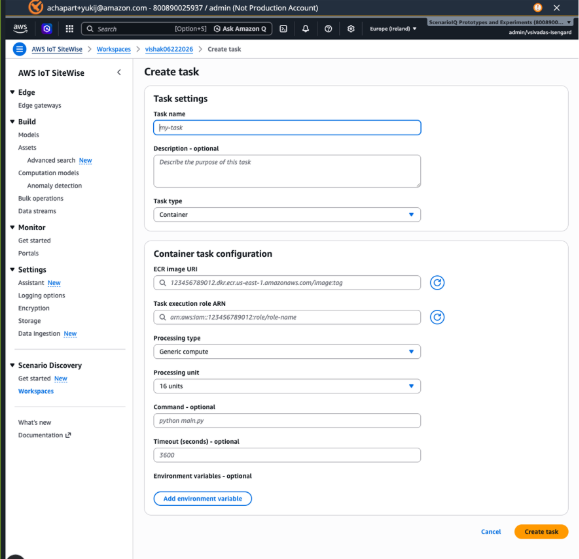
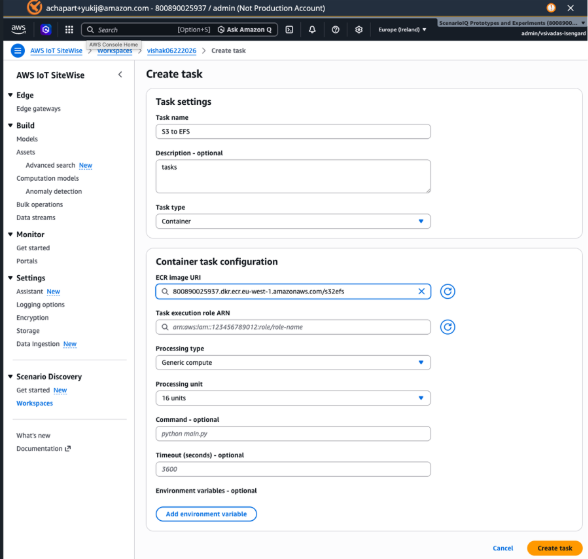
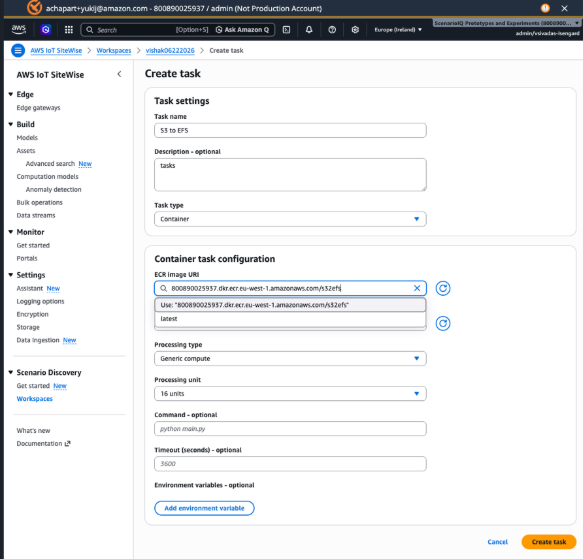
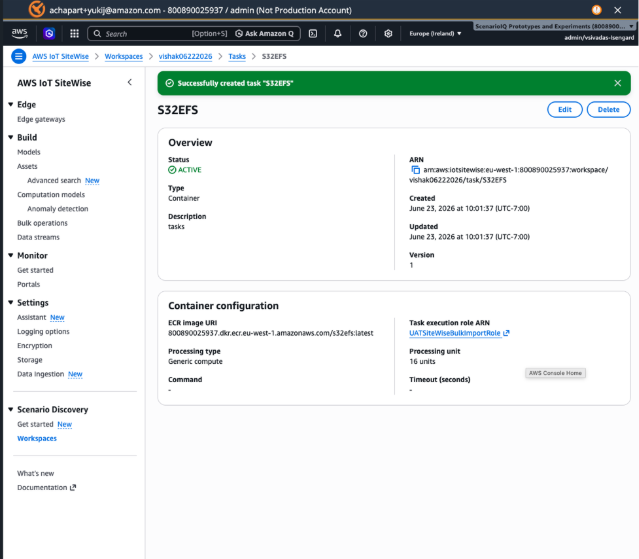
选择创建任务并填写基本详细信息:为任务命名(例如,“S3 to EFS”),添加可选描述,然后选择 “容器” 作为任务类型。
第 3 步:配置容器镜像和执行角色
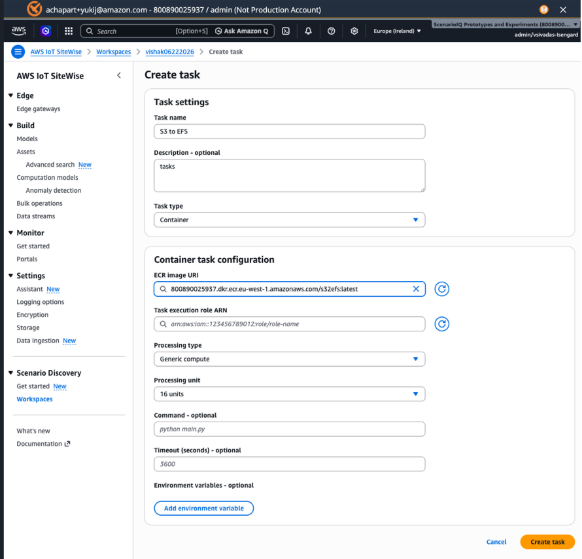
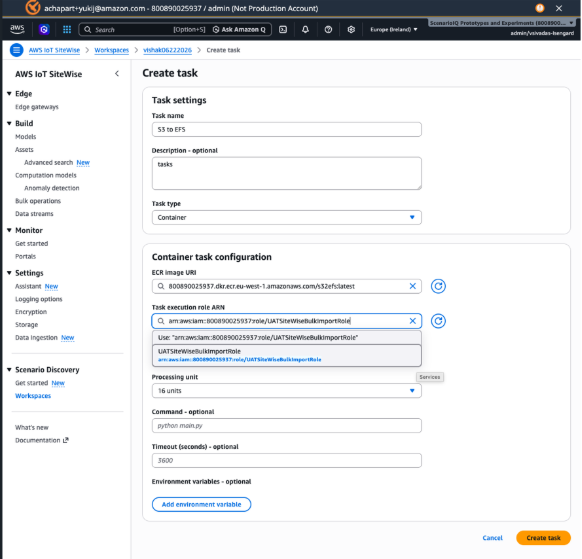
输入容器镜像的 ECR URI(您在亚马逊弹性容器注册表中的镜像地址),将任务指向您的容器镜像。然后选择向容器授予访问 Amazon 资源(如 S3 存储桶)权限的 IAM 执行角色。
步骤 4:设置处理参数
选择您的任务需要多少计算量。对于标准 CPU 工作负载,选择 “通用计算”,对于 GPU 任务,选择 “硬件加速”。选择处理单元大小(例如 16 个单位),设置启动命令(例如,“python main.py”),然后以秒为单位指定超时(例如,3600 表示一小时)。
第 5 步:添加环境变量
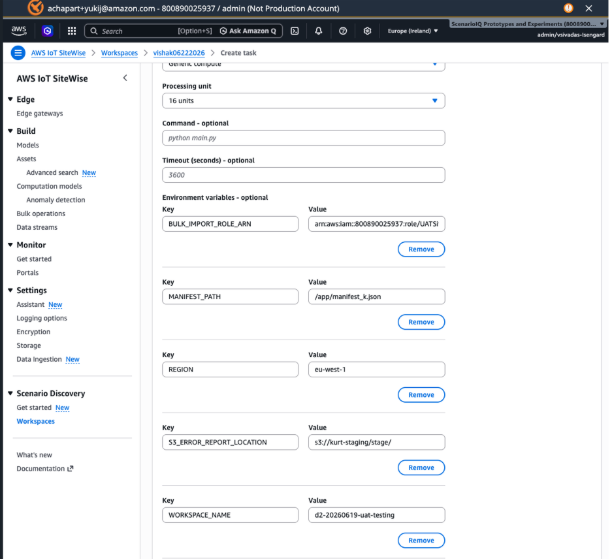
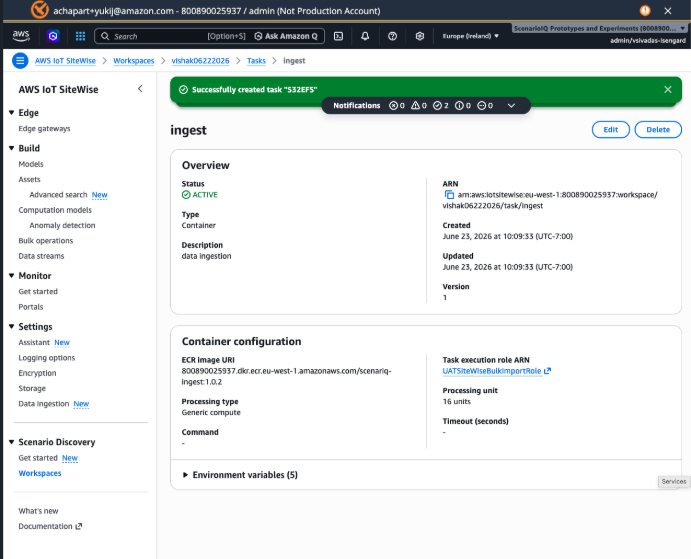
添加容器在运行时需要的任何环境变量。常见示例包括 Amazon 区域、S3 存储桶路径、工作空间名称和角色 ARN。这些是配置容器行为的键值对。
第 6 步:查看创建的任务
选择 “创建任务” 以完成。绿色横幅确认任务已成功创建。您可以在任务详细信息页面上查看所有设置,如果需要进行更改,则可以使用 “编辑” 或 “删除” 按钮。
第 7 步:创建其他任务
根据需要为您的管道创建其他任务。例如,您可以创建单独的 “采集” 任务来处理场景发现中的数据摄取。每个任务可以使用不同的容器镜像和配置。
步骤 8:导航到 “管道” 选项卡
返回工作区并选择 “管道” 选项卡。选择 “创建管道” 以开始构建多步骤工作流程。为您的管道命名(例如,“ingestdatapipeline”)和可选描述。
第 9 步:向管道添加计算节点
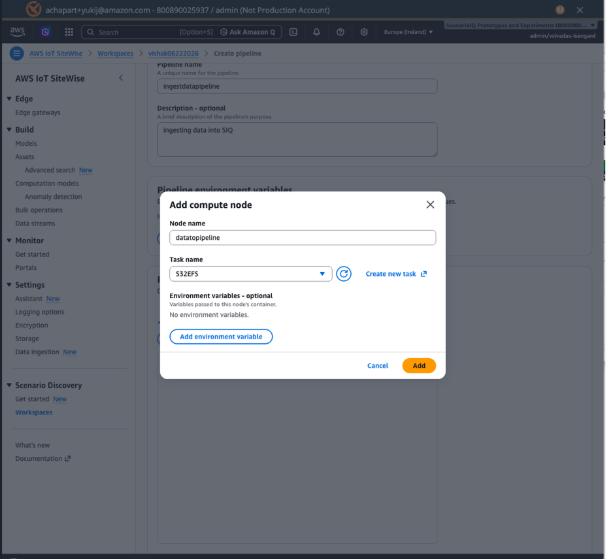
选择 + 添加节点向您的管道添加处理步骤。为每个节点命名并选择它应该运行的任务。您可以将多个节点添加到链式任务中(例如,首先从 S3 传输数据,然后将其提取到场景发现中)。
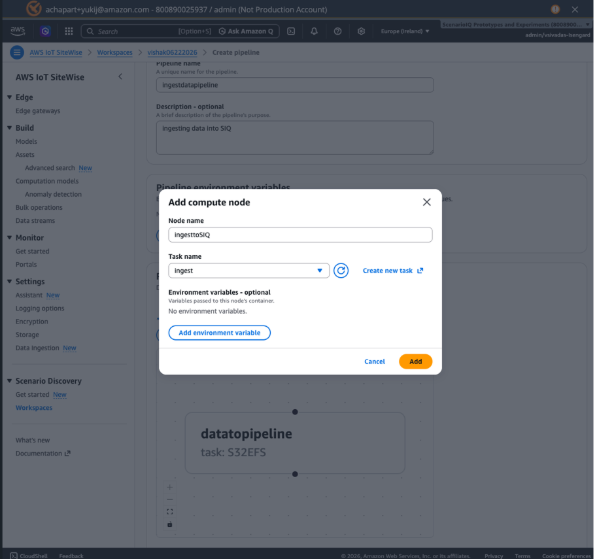
第 10 步:定义管道图和依赖关系
可视化编辑器将您的管道显示为流程图。用箭头连接节点以定义执行顺序。例如,数据传输节点首先运行,而摄取节点仅在完成后启动。当您的图表看起来正确时,选择创建管道。
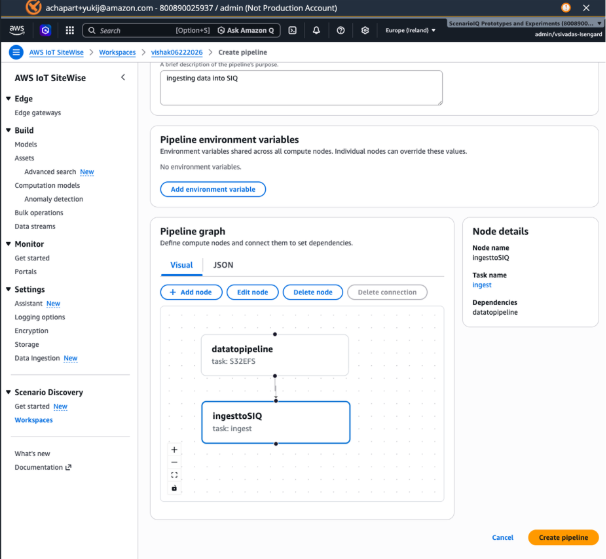
步骤 11:查看创建的管道
创建后,管道详细信息页面将确认您的管道处于活动状态并显示其结构。您可以查看节点图、执行历史记录,并使用顶部的按钮编辑、删除、监控或执行管道。
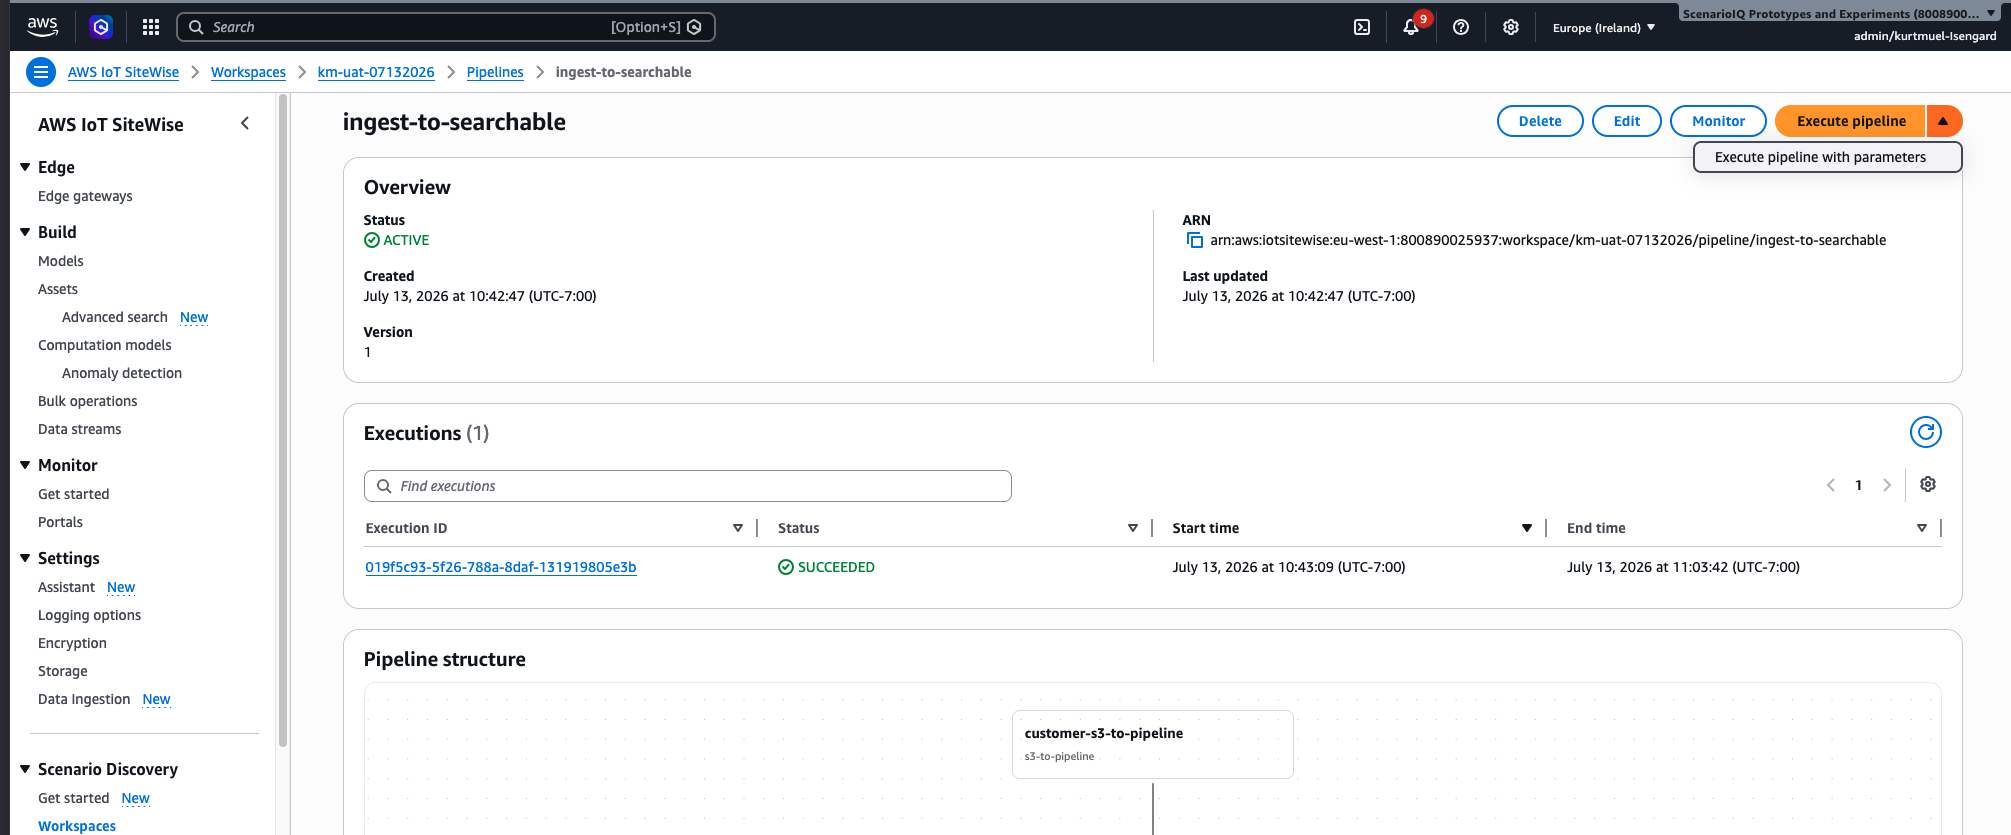
第 12 步:监控管道执行
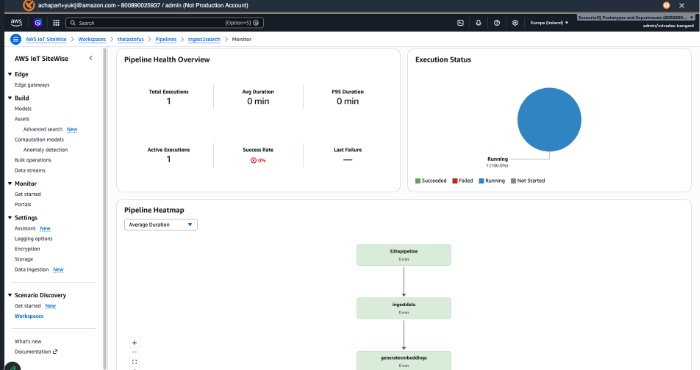
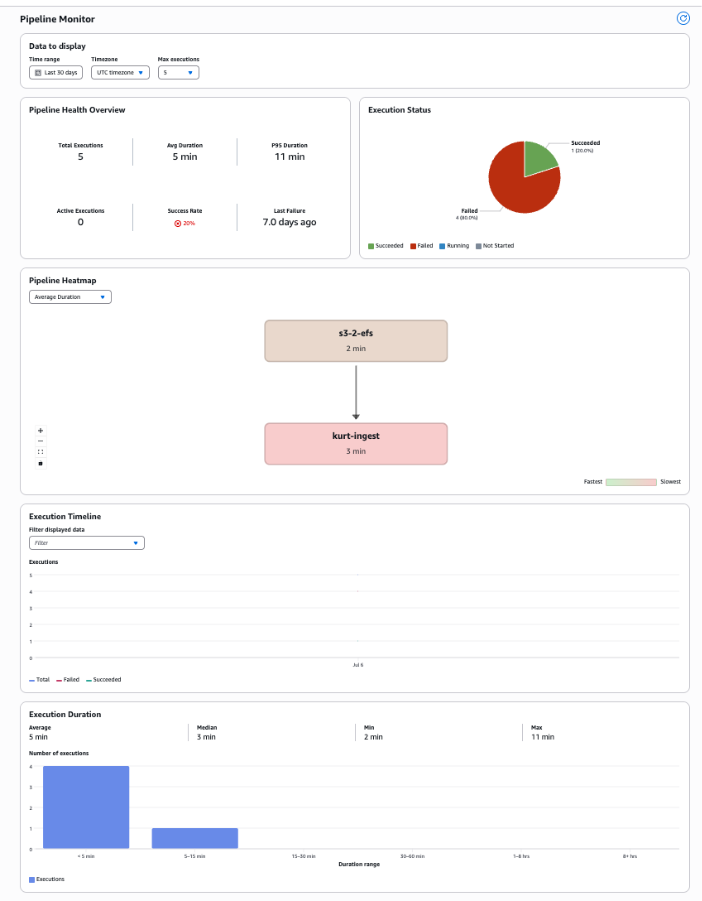
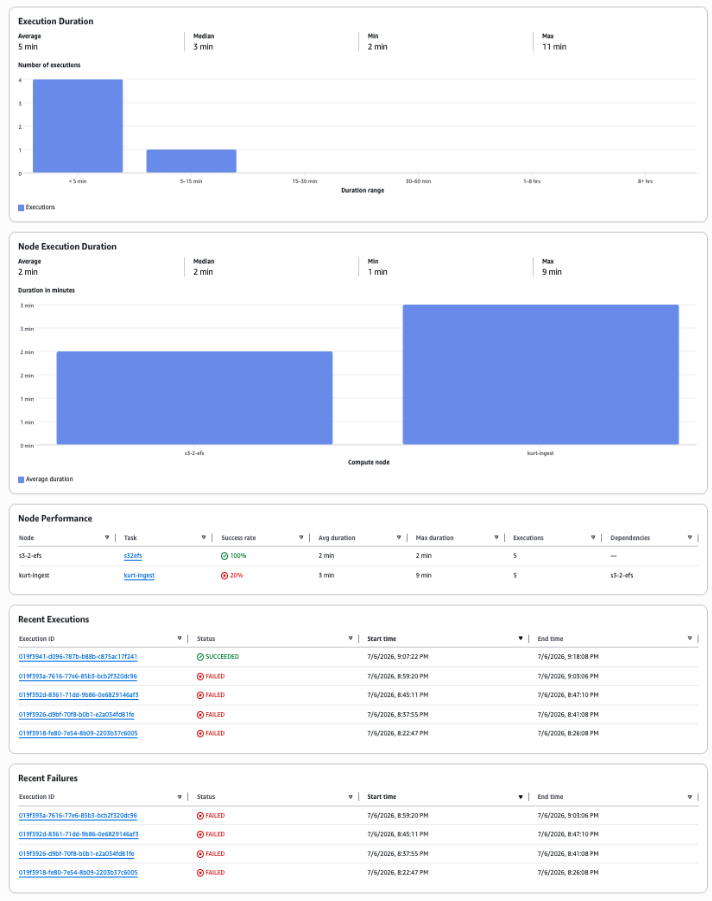
监控屏幕实时显示管道的进度。每个节点均采用颜色编码:蓝色表示正在运行,绿色表示已完成,红色表示失败。选择任意节点以查看其详细信息和访问日志以进行故障排除。
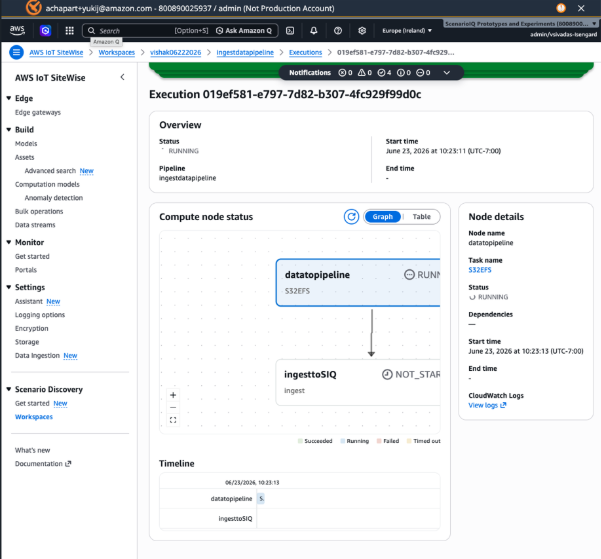
您可以通过选择 “监控” 来监控数据管道。监控选项卡显示特定管道在一段时间内的执行历史记录。您可以查看管道中不同节点的执行时间、成功执行的次数、失败的执行次数以及上次执行管道的时间。此外,监控窗口还向您显示了在整个管道使用过程中多次运行中每个节点的平均执行时间。
步骤 13:验证管道已完成
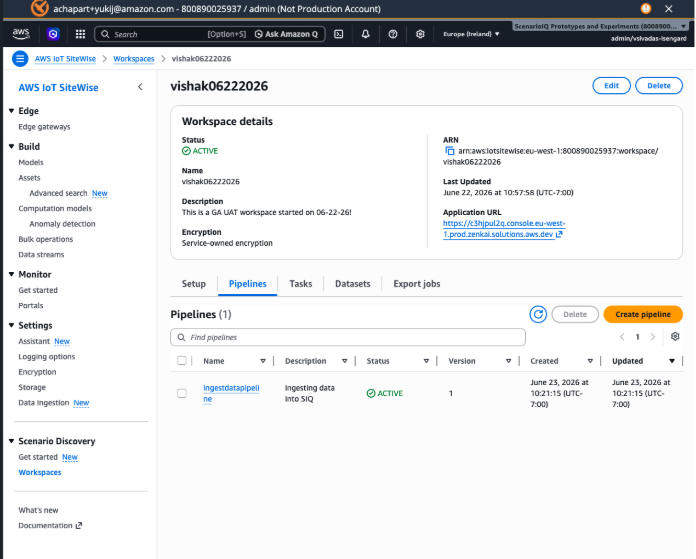
管道完成后,返回 “管道” 选项卡以确认其成功运行。您的管道列出了其状态,您可以随时重新运行它。
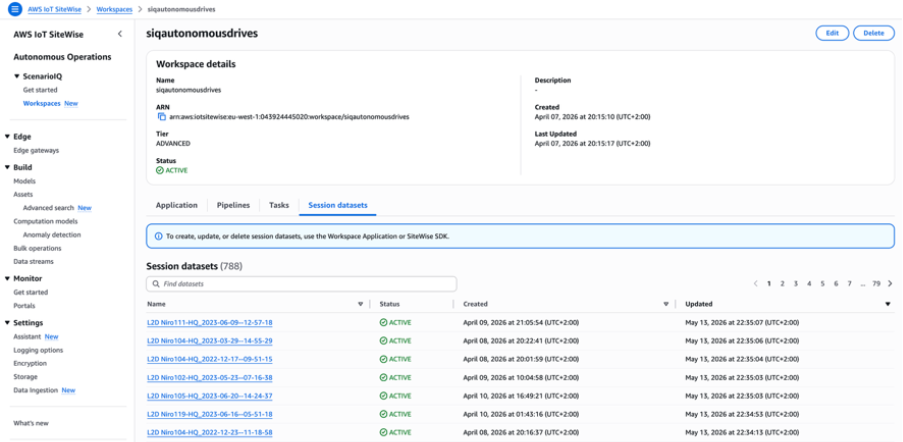
步骤 14:验证会话数据集
摄取完成后,检查工作空间中的会话数据集选项卡以确认您的数据现在可用。您应该看到以 “活动” 状态列出的录音。