本文属于机器翻译版本。若本译文内容与英语原文存在差异,则一律以英文原文为准。
Connect 连接到您的可观测性工具
人工智能通过与亚马逊托管 Grafana、自托管 Grafana 和其他平台等工具兼容的区域 PromQL 终端节点向亚马逊发布指标 CloudWatch,而不是使用亚马逊中的 SageMaker A SageMaker I Insights 控制面板,而是 CloudWatch 通过与 Prometheus-based 工具(包括亚马逊托管 Grafana、自托管 Grafana 和其他平台)兼容的区域 PromQL 终端节点向亚马逊发布指标。 PromQL-compatible 您使用 Amazon 签名版本 4 (Sigv4) 进行身份验证。本节介绍如何配置 Prometheus 数据源、导入预先配置的仪表板模板以及如何为推理指标编写 PromQL 查询。
PromQL 端点和身份验证
| 设置 | 值 |
|---|---|
| 端点 URL | https://monitoring. |
| Auth | 签名版本 4 (Sigv4) |
| 服务 | monitoring |
| 所需的权限 | cloudwatch:QueryMetrics,
cloudwatch:GetMetricData,
cloudwatch:ListMetrics |
在 Grafana 中设置 Prometheus 数据源
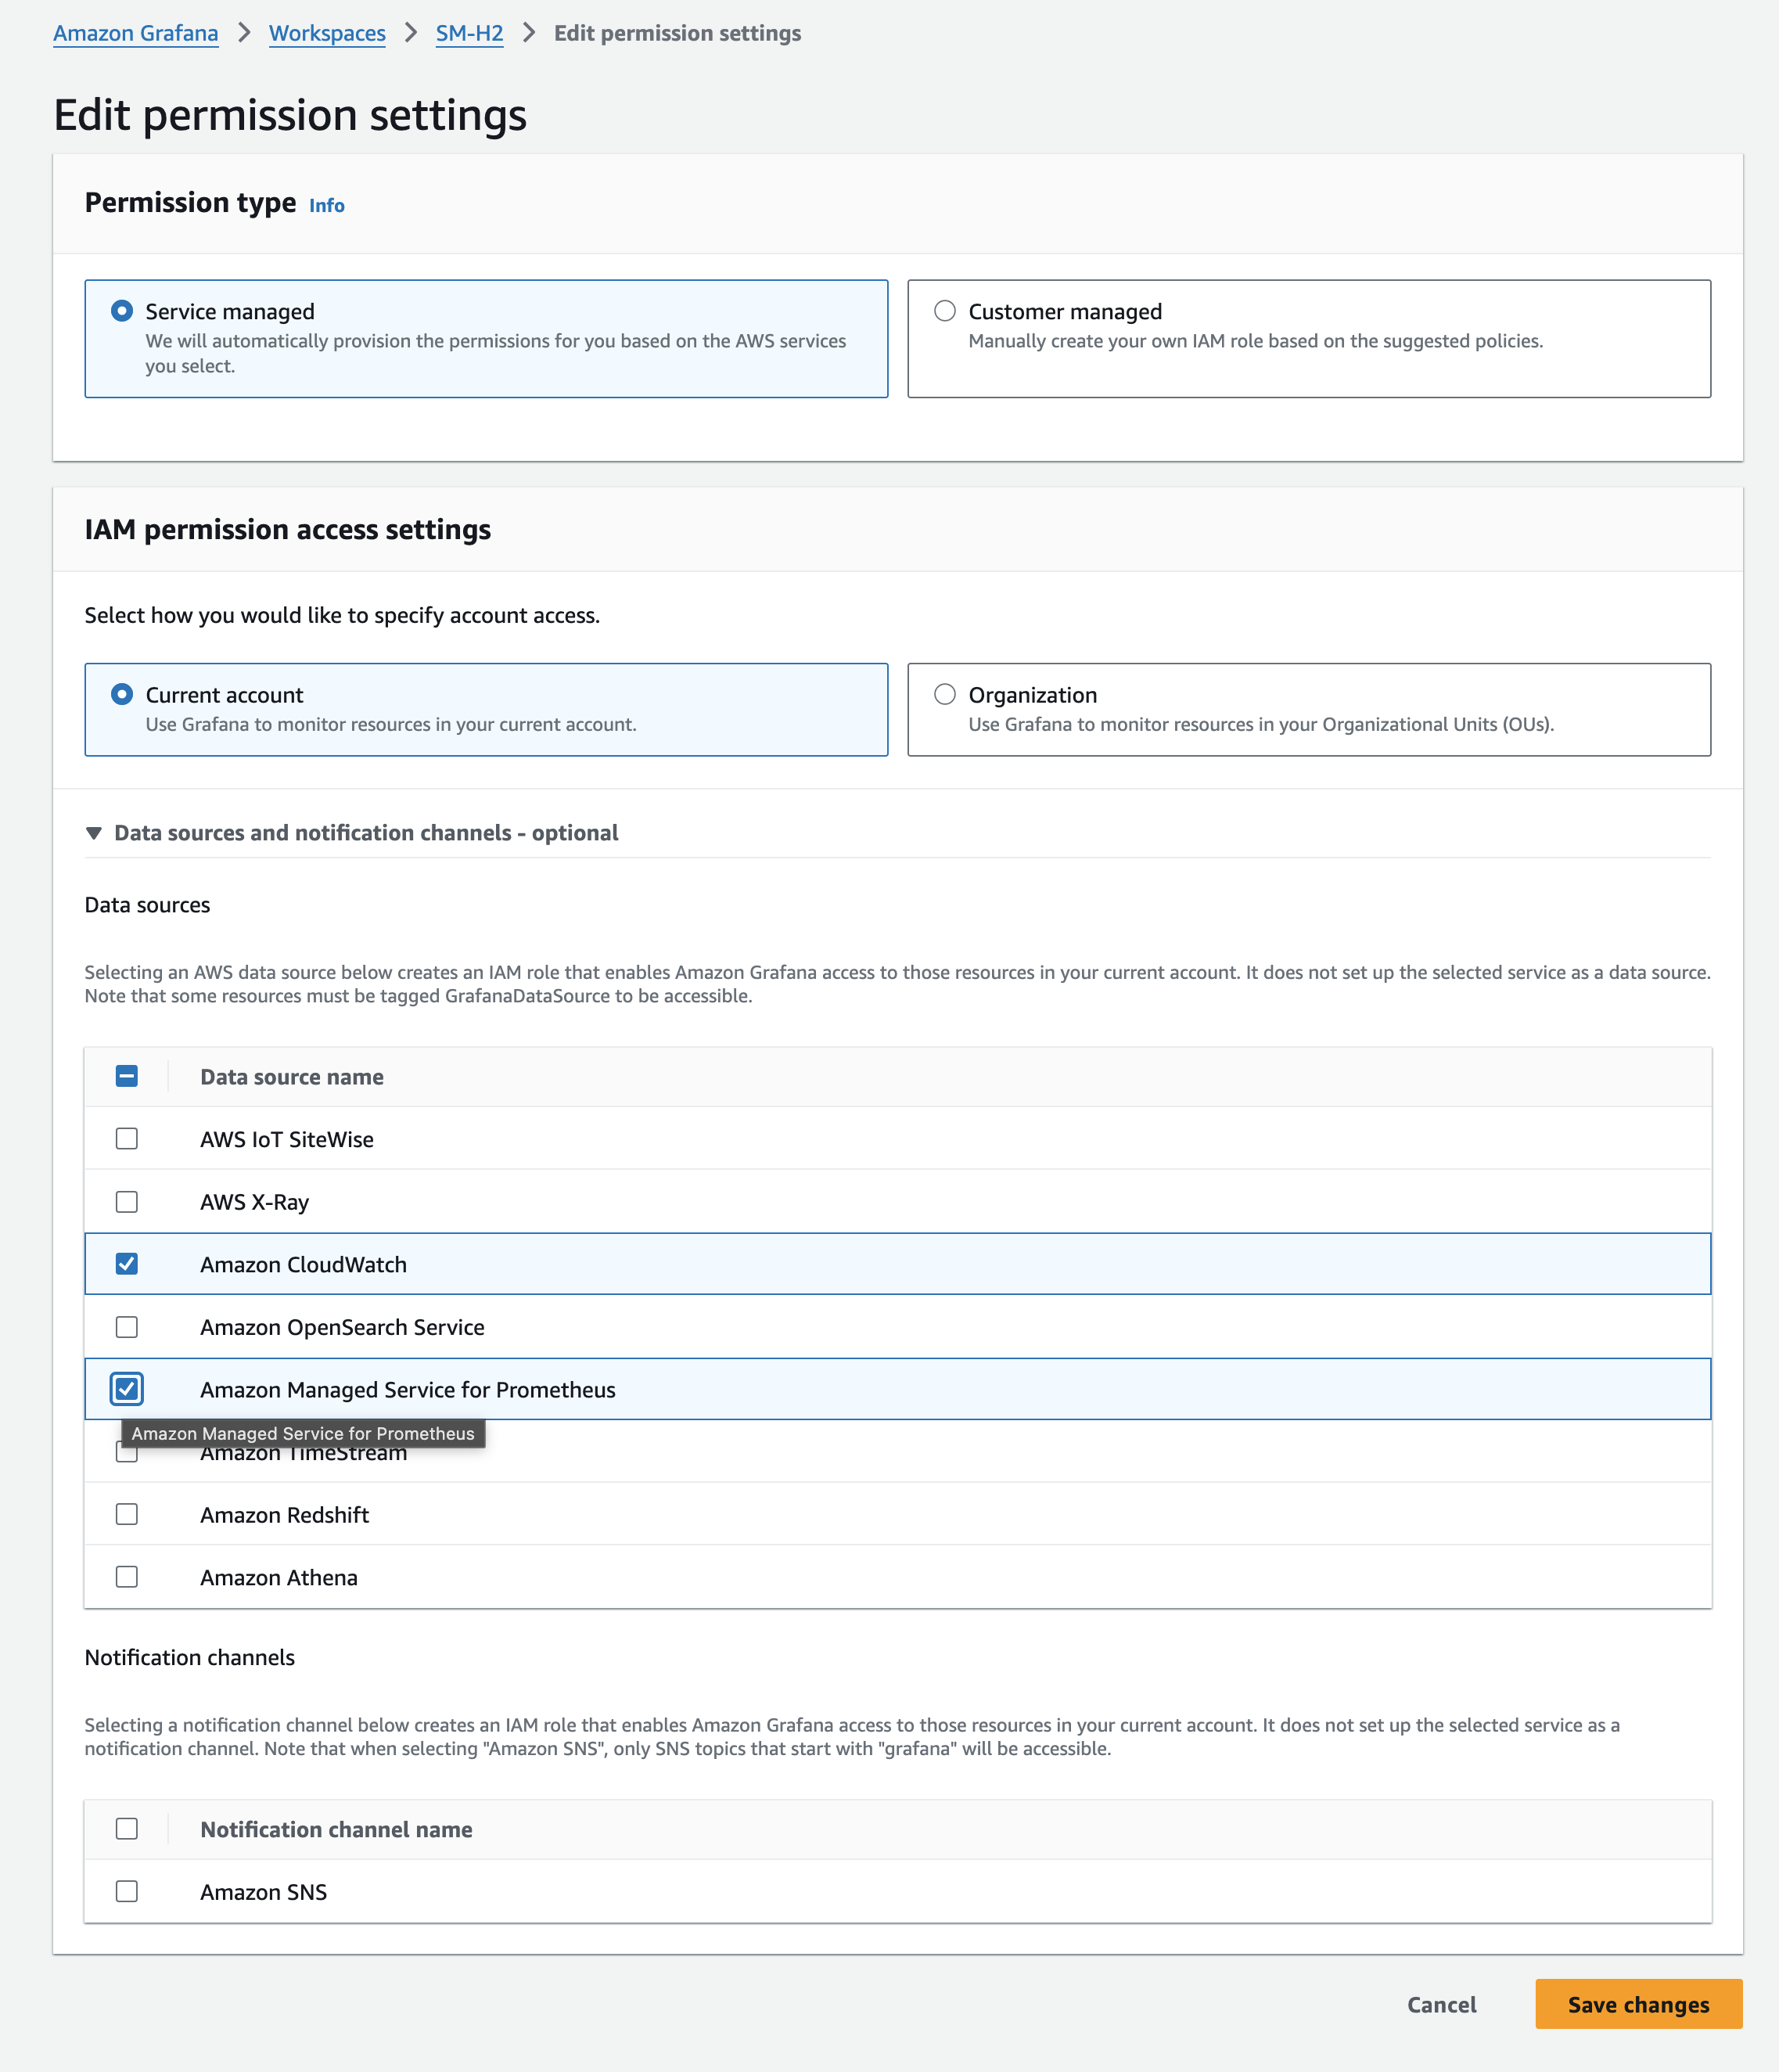
选项 1:亚马逊托管 Prometheus(推荐 AMG 使用)
-
打开 AMG 工作空间 → 数据源 → 添加 → 适用于 Prometheus 的亚马逊托管服务
-
名称:
SageMaker Inference (PromQL)region -
URL:
https://monitoring.region.amazonaws.com -
默认区域:
region -
服务:
monitoring -
单击 “保存并测试”
选项 2:标准 Prometheus 数据源
{
    "name": "SageMaker Inference (PromQL)",
    "type": "prometheus",
    "url": "https://monitoring.region.amazonaws.com",
    "access": "proxy",
    "jsonData": {
        "sigV4Auth": true,
        "sigV4AuthType": "default",
        "sigV4Region": "region",
        "sigV4Service": "monitoring",
        "httpMethod": "POST"
    }
}
IAM 策略
{
    "Version": "2012-10-17",
    "Statement": [{
        "Effect": "Allow",
        "Action": [
            "cloudwatch:QueryMetrics",
            "cloudwatch:DescribeMetrics",
            "cloudwatch:GetMetricData",
            "cloudwatch:ListMetrics"
        ],
        "Resource": "*"
    }]
}
导入仪表板模板
-
SageMaker AI 控制台 → 端点 → “连接到你的可观测性工具” → “仪表板模板” 选项卡
-
点击下载 Grafana 模板 (JSON)
-
在 Grafana 中:仪表板 → 导入 → 上传 JSON
-
选择您的数据源 → 导入
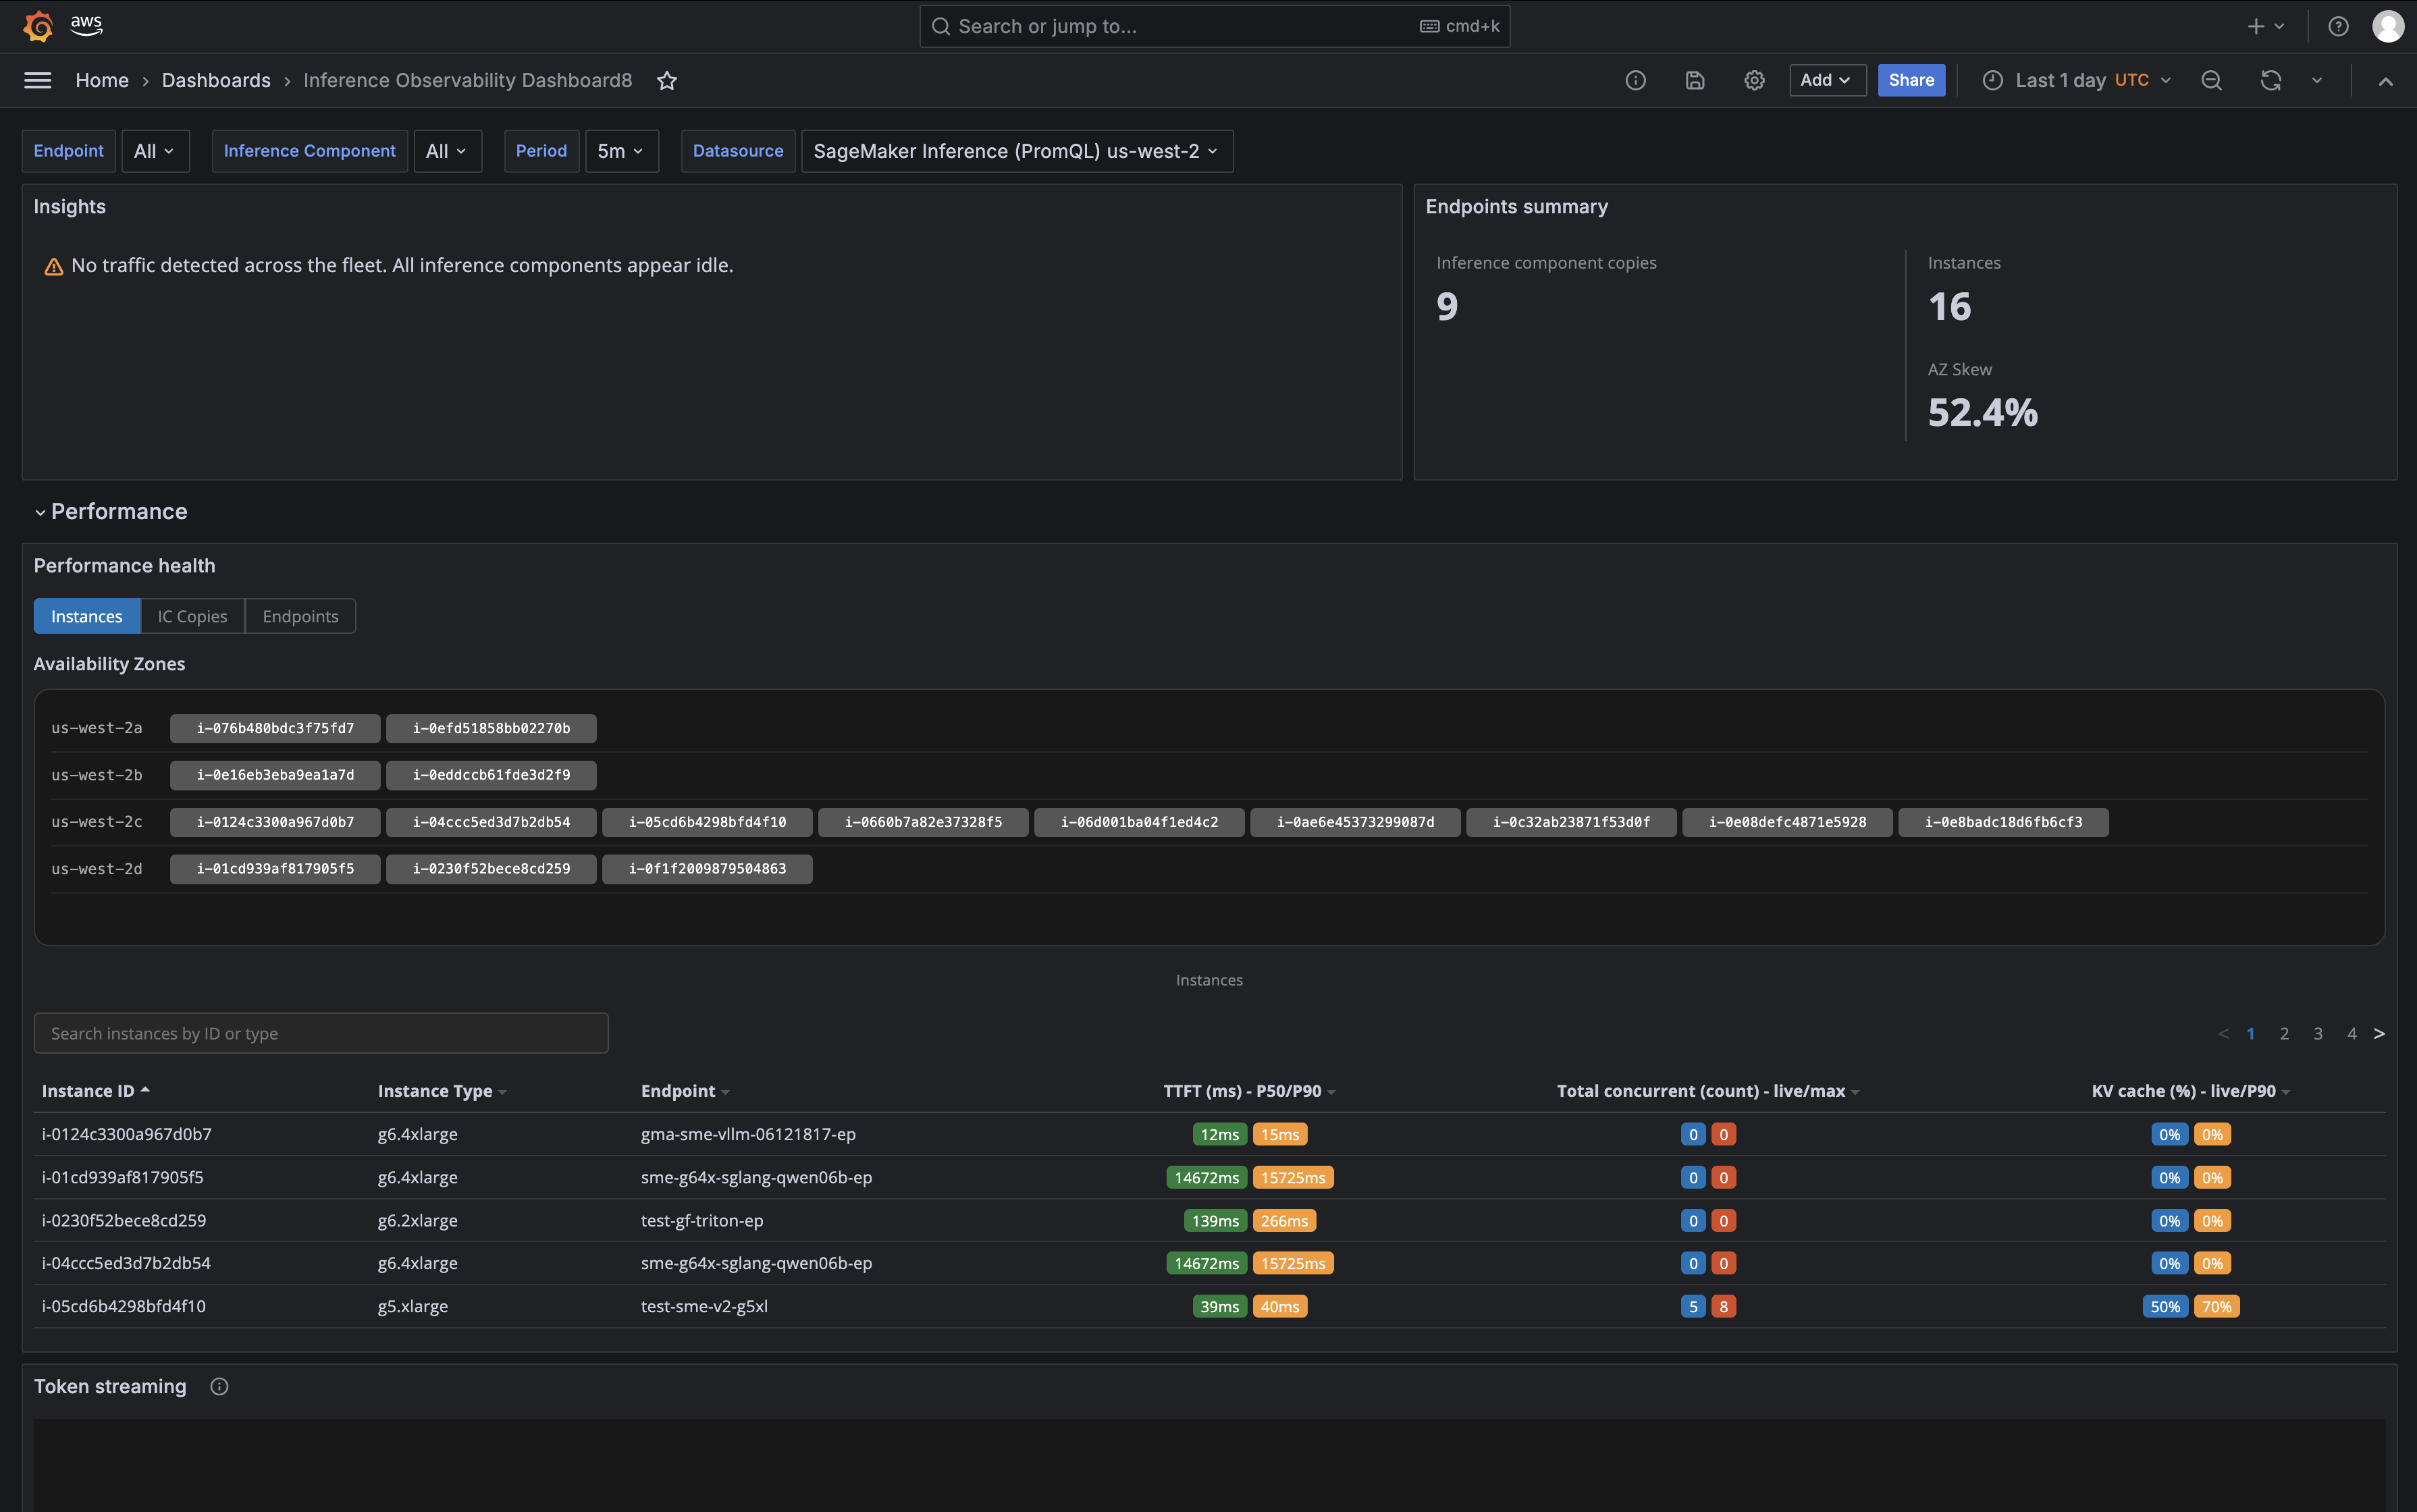
该模板有 3 个部分(性能、容量、可靠性)与 SageMaker AI Insights 仪表板相匹配。
PromQL 中提供了 oTel 标签
在 PromQL 中,带点的标签必须用单引号括起来:
| 标签 | 说明 |
|---|---|
'aws.sagemaker.endpoint.name' |
端点名称 |
'aws.sagemaker.inference_component.name' |
身份证名称 |
'aws.sagemaker.inference_framework' |
框架(vllm、sglang) |
'aws.sagemaker.variant.name' |
变体名称 |
@resource.host.id |
实例 ID |
@resource.cloud.availability_zone |
可用区 |
@resource.host.type |
实例类型 |
PromQL 查询示例
# GPU utilization per IC
avg by ('aws.sagemaker.inference_component.name') (
    DCGM_FI_DEV_GPU_UTIL{'aws.sagemaker.endpoint.name'="$endpoint"})

# Token throughput (total TPS)
sum(rate(vllm_prompt_tokens_total{'aws.sagemaker.endpoint.name'="$endpoint"}[5m]))
    + sum(rate(vllm_generation_tokens_total{'aws.sagemaker.endpoint.name'="$endpoint"}[5m]))

# TTFT P99
histogram_quantile(0.99, sum by (le) (
    rate(vllm_time_to_first_token_seconds_bucket{'aws.sagemaker.endpoint.name'="$endpoint"}[5m])))

# KV cache utilization
avg(vllm_kv_cache_usage_perc{'aws.sagemaker.endpoint.name'="$endpoint"})

# Queue depth per IC
sum by ('aws.sagemaker.inference_component.name') (
    vllm_num_requests_waiting{'aws.sagemaker.endpoint.name'="$endpoint"})

# CPU utilization (computed)
100 * (1 - avg by ('aws.sagemaker.endpoint.name') (
    rate(node_cpu_seconds_total{mode="idle",'aws.sagemaker.endpoint.name'="$endpoint"}[5m])))

# Error rate (5XX)
sum(rate(Response_5XX_total{'aws.sagemaker.endpoint.name'="$endpoint"}[5m]))